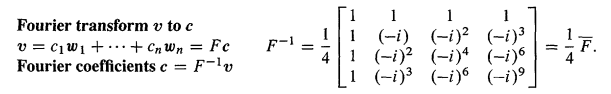Linear Transformation
综合V31,V32,V33
先提前阅读 <#Lk1,Lk2> 理清楚概念!
还没有理解的是:为何A A + , A + A AA^+,A^+A A A + , A + A
The Idea of a Linear Transformation
综合V31一部分
线性变换是学习线代的另一个开始点.即使不知道什么是矩阵,也能理解线性变换.物理学家,并不关心坐标系和坐标值,他们只关心如何描述这一变换.在大多数情况下,每个线性变换都对应一个矩阵,而矩阵的背后,正是线性变换的概念.
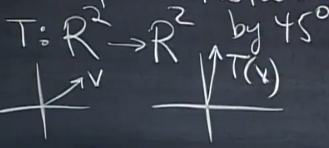
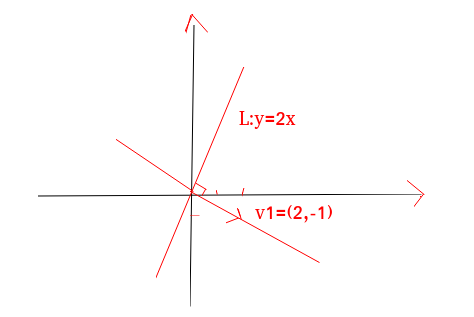
例V1 不通过任何矩阵,也可以通过线性变换描述一个投影.如,把 R 2 R^2 R 2 R 2 R^2 R 2 R 2 → R 2 R^2 \rightarrow R^2 R 2 → R 2 T(v),T(v)就是投影到直线上的向量,T就就像是一个函数,对某输入进行变换,得到一个输出.你看到,这里其实没有坐标.事实上,也可以把坐标轴去掉
当矩阵A乘以一个向量 v,就变换 v 为另外一个向量 Av.输入是 v,输出是 T ( v ) = A v T(v) = Av T ( v ) = A v T 的概念和函数是一样的,输入是 x,输出是 f(x).我们用矩阵乘以一个向量 v ,或者用函数计算一个数字 x.更重要的是,一次性看清楚所有 v 的变换.当所有v都乘以A的时候,我们变换的是所有v组成的空间V
A把 v 变换为 Av,把 w 变换为 Aw ,可以知道 u = v + w u = v+w u = v + w Au 就是 A v + Aw Av +Aw A v + Aw T(v) = Av 是线性变换
一个变换T对每一个 V 当中的输入向量 v 都给出1个输出 T(v). 如果对与所有的v,w,T变换都满足下面2个条件,那么这个T变换就是线性的(linear) :
T ( v + w ) = T ( v ) + T ( w ) T(v+w) = T(v) +T(w) T ( v + w ) = T ( v ) + T ( w ) T ( c v ) = c T ( v ) T(cv) = cT(v) T ( c v ) = c T ( v )
这其实就是向量的加法和数乘.线性变换应该保证这两种运算的不变性。 如投影就是一种线性变换,可以验证这一点.如果v变成了原来的两边,投影也是,如果变成-v,投影的方向也会相反.
如果输入 v = 0 ,输出 T(v) 必须是0.零向量通过线性变换一定是0向量,所以可以通过T(0)来判断是不是线性变换. .所以例V2平面平移不是一个线性变换。我们可以把 (1,2) 的要求组成一个:
> Liear Transformation: > T ( c v + d w ) 必须等于 c T ( v ) + d T ( w ) > > > (M1) > \color{orange} \text{Liear Transformation:} \qquad
> \color{white} T(cv+dw) \quad \text{必须等于} \quad cT(v) +dT(w)
>
> \tag{M1}
> > Liear Transformation: > T ( c v + d w ) 必须等于 c T ( v ) + d T ( w ) >>> ( M1 )
上式的意思就是:任何v,w线性组合的线性变换,肯定会产生对T(v),T(w)的同样的线性组合 。而矩阵乘法是线性的:A ( c v + d w ) = c A v + d A w A(cv+dw) = cAv +dAw A ( c v + d w ) = c A v + d A w
例V2 线性变换是有很多限制的.假设 T 把 u 0 u_0 u 0 T ( v ) = v + u 0 , T ( w ) = w + u 0 T(v) = v + u_0,T(w) = w + u_0 T ( v ) = v + u 0 , T ( w ) = w + u 0 T ( v + w ) = v + w + u 0 T(v+w) = v+w+u_0 T ( v + w ) = v + w + u 0 T(v) + T(w) 是不等价的
v + w + u 0 不等于 T ( v ) + T ( w ) = v + u 0 + w + u 0 . Shift is not linear! \quad v + w + u _ { 0 } \quad \text { 不等于 } \quad T ( v ) + T ( w ) = v + u _ { 0 } + w + u _ { 0 } .
\quad \color{orange} \text{Shift is not linear!} v + w + u 0 不等于 T ( v ) + T ( w ) = v + u 0 + w + u 0 . Shift is not linear! 例外就是当 u 0 = 0 u_0= 0 u 0 = 0 T ( v ) = v T(v) = v T ( v ) = v 恒等变换(identity transformation) ,明显是线性的,这时输入空间V = 输出空间W(sp-mark-A1)
线性-平移(linear-plus-shift)的变换 T ( v ) = A v + u 0 T(v) = Av + u_0 T ( v ) = A v + u 0 仿射(affine) .虽然 T 不再是线性的,但是直线还是直线.计算机图形学的仿射变换将在 <01-08 #6> 学习,因为我们必须能够移动图片啊
例1. 选择 a = (1,3,4),设 T(v) 是点乘: a∙v,那么输入是 v = ( v 1 , v 2 , v 3 ) v=(v_1,v_2,v_3) v = ( v 1 , v 2 , v 3 ) T ( v ) = a ⋅ v = v 1 + 3 v 2 + 4 v 3 . T(v) = a\cdot v = v_1 + 3v_2 + 4v_3. T ( v ) = a ⋅ v = v 1 + 3 v 2 + 4 v 3 . V = R 3 V=R^3 V = R 3 W = R 1 W = R^1 W = R 1 A = [ 1 , 3 , 4 ] A = [1,3,4] A = [ 1 , 3 , 4 ] T ( v ) = A v T(v) = Av T ( v ) = A v
如果输出包含了乘积或者长度: v 1 2 v_1^2 v 1 2 v 1 v 2 v_1 v_2 v 1 v 2 ∣ v ∣ |v| ∣ v ∣
例2. 长度 T ( v ) = ∣ v ∣ T(v) = |v| T ( v ) = ∣ v ∣ -2,长度还是翻倍,而不是乘以-2,明显错了。要求(1) 是 ∣ v + w ∣ = ∣ v ∣ + ∣ w ∣ |v+w| =|v|+|w| ∣ v + w ∣ = ∣ v ∣ + ∣ w ∣ ∣ c v ∣ = c ∣ v ∣ |cv| = c|v| ∣ c v ∣ = c ∣ v ∣
∣ v + w ∣ ≤ ∣ v ∣ + ∣ w ∣ |v+w|\le |v|+|w| ∣ v + w ∣ ≤ ∣ v ∣ + ∣ w ∣ ∣ − v ∣ ≠ − ∣ v ∣ |-v| \ne -|v| ∣ − v ∣ = − ∣ v ∣
例3.(重要) T是一个把任何向量旋转30度的变换.定义域(domain)是xy平面(所有输入向量v来自的地方),值域(range)也是xy平面(所有旋转后的向量T(v)).没有矩阵的时候,我们这样描述T:旋转30度
旋转是线性的吗?是的,我们可以旋转2个向量,然后加载一起,和T(v) + T(w)和T(v+w)是一样的.整个输入平面都旋转了.
例V3 再看一个旋转45度的例子.平面内的一个向量映射到平面内另一个向量,任何输入向量被逆时针旋转45度
如果v翻倍,旋转后的向量同样翻倍,对于v+w,无论先旋转后加,还是加后旋转,结果是一样的.因此这是线性变换.
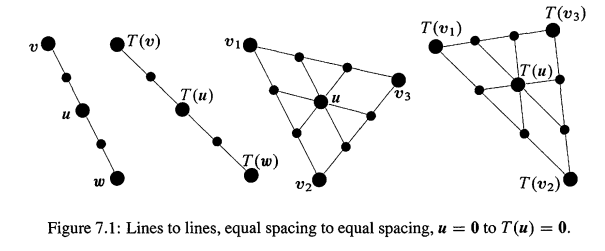
Lines to Lines,Triangles to Triangles
Fig7.1最左边2条直线,展示了输入空间的 v 到 w 的直线,也展示了输出空间的 T(v) 到 T(w) 的直线.线性化告诉我们:输入线上的每个点,都到了输出线的点上.而且,等距的点在输出空间还是等距的点(Equally spaced points go to equally spaced points). 输入线上的中心点 u = 1 / 2 v + 1 / 2 w u = 1/2 v+1/2 w u = 1/2 v + 1/2 w T ( u ) = 1 / 2 T ( v ) + 1 / 2 T ( w ) T(u) = 1/2 T(v)+1/2 T(w) T ( u ) = 1/2 T ( v ) + 1/2 T ( w )
Fig7.1右边2增加了一维.现在我们有3个顶点 v 1 , v 2 , v 3 v_1,v_2,v_3 v 1 , v 2 , v 3 T ( v 1 ) , T ( v 2 ) , T ( v 3 ) T(v_1),T(v_2),T(v_3) T ( v 1 ) , T ( v 2 ) , T ( v 3 ) u = 1 / 3 ( v 1 + v 2 + v 3 ) u = 1/3(v_1+v_2+v_3) u = 1/3 ( v 1 + v 2 + v 3 ) T ( u ) = 1 / 3 ( T ( v 1 ) + T ( v 2 ) + T ( v 3 ) T(u) = 1/3 (T(v_1 )+T(v_2 )+T(v_3 ) T ( u ) = 1/3 ( T ( v 1 ) + T ( v 2 ) + T ( v 3 )
线性化的规则,可以扩展到3个或者n个向量的组合:
> Linearity: > u = c 1 v 1 + . . . + c n v n > transform to > T ( u ) = c 1 T ( v 1 ) + . . . + c n T ( v n ) > (1) > \text{Linearity:} \quad
> u=c_1v_1+...+c_nv_n
> \quad \text{transform to}\quad
> T(u) = c_1T(v_1)+...+c_nT(v_n) \tag{1}
> > Linearity: > u = c 1 v 1 + ... + c n v n > transform to > T ( u ) = c 1 T ( v 1 ) + ... + c n T ( v n ) > ( 1 ) **注意:**变换有自己的语言,当没有矩阵的时候,我们不能讨论列空间.但概念是可以继续使用的。如
列空间包含了所有的输出Av
零空间包含的是所有Av = 0的输入
上面2个概念在变换可以用"值域(range) "和"内核(kernel) "来表示:
T的值域 = 所有输出 T(v) 的集合 (对应列空间Av)
T的内核 = 所有 T(v) = 0 的输入的集合(对应零空间)
值域在输出空间W.内核在输入空间V.当 T 可用一个矩阵乘法表示的时候,就有 T ( v ) = A v T(v) = Av T ( v ) = A v
Example of Transformation(mostly linear)
例4. 直接投影任何3维向量到xy平面,那么 T ( x , y , z ) = T ( x , y , 0 ) T(x,y,z) = T(x,y,0) T ( x , y , z ) = T ( x , y , 0 )
例5. 投影任何3维向量到水平面z = 1,那么 v = ( x , y , z ) v = (x,y,z) v = ( x , y , z ) T ( v ) = ( x , y , 1 ) T(v) = (x,y,1) T ( v ) = ( x , y , 1 ) v = 0 投影到 T ( v ) = 0 T(v) = 0 T ( v ) = 0
3-3矩阵A乘以任何3维向量,这个 T ( v ) = A v T(v) = Av T ( v ) = A v
T ( v + w ) = A ( v + w ) 确实等于 A v + A w = T ( v ) + T ( w ) T ( v + w ) = A ( v + w ) \quad \text { 确实等于 } \quad A v + A w = T ( v ) + T ( w ) T ( v + w ) = A ( v + w ) 确实等于 A v + A w = T ( v ) + T ( w ) 例6. 假设T变换可用矩阵A表示,并且A是可逆矩阵.那么T的内核是0向量,值域 W 等于定义域 V
sp:可逆矩阵,只有零向量能产生Ax = 0,并且因为可逆,各列独立,所以列空间 Av 等于矩阵A本身的列生成的空间
另外一个线性变换是乘以 A − 1 A^{−1} A − 1 T − 1 T^{−1} T − 1
T − 1 ( T ( v ) ) = v 符合矩阵乘法 A − 1 ( A v ) = v T^{-1}(T(v)) =v \quad \text{符合矩阵乘法} \quad A^{-1}(Av) = v T − 1 ( T ( v )) = v 符合矩阵乘法 A − 1 ( A v ) = v 思考1个问题: 所有的输入空间 V = R n V = R^n V = R n W = R m W = R^m W = R m 线性变换 ,都可以由矩阵产生吗?当线性的 T 被描述为旋转或者投影....等等的时候,总会有一个矩阵隐藏在这个变换T下吗?
是的 .这是一种学习线性代数的方式,不是从矩阵开始学起.下一节我们将看到,这一切都是矩阵
sp:注意,必须是线性变换。也就是说,一切线性变换都可以用一个矩阵表示!
Linear Transformation of the plane
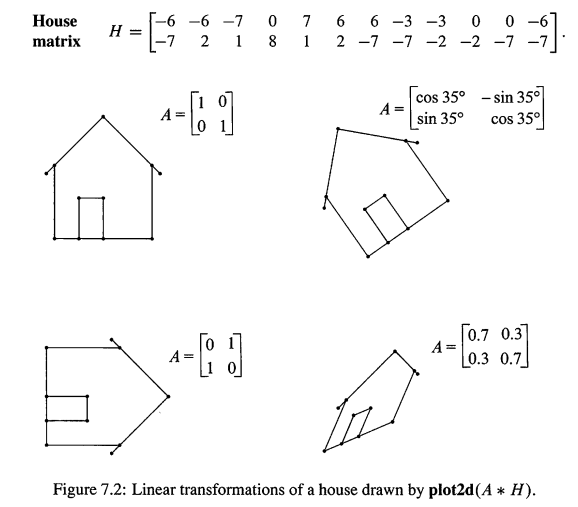
看一个变换的效果,比定义它有趣多了.当一个2-2矩阵A乘以所有 R 2 R^2 R 2 v,它们变换为11向量 Av .v之间的直线变成Av之间的直线(这个变换是线性的!).把A作用到一个标准的房子上,可以产生一个新的房子--可能拉伸或者旋转等等
矩阵H的列是第1个房子的11个顶点,矩阵A乘以H产生了其他形状的房子
sp:plot2d是TeachingCode里面的函数
一个变换T,把输入空间的每一个v,变换成输出空间的T(v)
如果 T ( v + w ) = T ( v ) + T ( w ) , T ( c v ) = c T ( v ) T(v+w) = T(v) + T(w),T(cv) = cT(v) T ( v + w ) = T ( v ) + T ( w ) , T ( c v ) = c T ( v )
线性组合,变换之后,还是线性组合 :T ( c 1 v 1 + … + c n v n ) = c 1 T ( v 1 ) + … + c n T ( v n ) T(c_1 v_1+…+ c_n v_n) = c_1 T(v_1 )+…+c_n T(v_n ) T ( c 1 v 1 + … + c n v n ) = c 1 T ( v 1 ) + … + c n T ( v n ) 只有当 v 0 = 0 v_0=0 v 0 = 0 T ( v ) = A v + v 0 T(v) = Av +v_0 T ( v ) = A v + v 0 T ( v ) = A ( v ) T(v) = A(v) T ( v ) = A ( v )
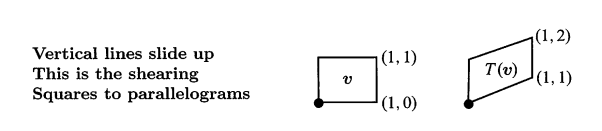
1. 消去矩阵 [ 1 0 1 1 ] \left[\begin{matrix} 1 & 0 \\ 1 & 1 \end{matrix} \right] [ 1 1 0 1 ] 偏移变换(sheer transformation) ,把 (x,y) 变换成 T(x,y) = (x,x+y).画出xy平面,然后看看向量 (1,0),(1,1) 变换成什么.对 x = 0 和 x= a 这样的垂直线,发生了什么?如果输入空间是单位正方形 0 ≤ x ≤ 1 , 0 ≤ y ≤ 1 0\le x \le 1,0\le y \le 1 0 ≤ x ≤ 1 , 0 ≤ y ≤ 1
解: x轴上的点 (1,0),(2,0) 被T变换成(1,1),(2,2),也就是水平的x轴变成逆时针旋转45度的直线(当然还经过原点).在y轴的点没有移动,因为 T(0,y) = (0,y) .y轴是 λ = 1 λ=1 λ = 1 .
sp: [ 1 0 1 1 ] \left[\begin{matrix} 1 & 0 \\ 1 & 1 \end{matrix} \right] [ 1 1 0 1 ] λ = 1 , 1 \lambda = 1,1 λ = 1 , 1 x = ( 0 , 1 ) x = (0,1) x = ( 0 , 1 )
而x = a的直线会向上移动a
2. 一个非线性 变换T,如输出输空间的每一个b,都是由输入空间的单独一个x变换而来的,那么它是可逆的(invertible).也就是:T(x) = b 恰好仅有一个解 .下面的哪些变换(x是实数)是可逆的,T − 1 T^{−1} T − 1 下面的变换没有一个是线性的,就算 T 3 T_3 T 3 .当你求解 T(x) = b 的时候,你在逆转T.
T 1 ( x ) = x 2 T _ { 1 } ( x ) = x ^ { 2 } T 1 ( x ) = x 2 T 2 ( x ) = x 3 T _ { 2 } ( x ) = x ^ { 3 } T 2 ( x ) = x 3 T 3 ( x ) = x + 9 T _ { 3 } ( x ) = x + 9 T 3 ( x ) = x + 9 T 4 ( x ) = e x T _ { 4 } ( x ) = e ^ { x } T 4 ( x ) = e x T 5 ( x ) = 1 x for nonzero x ′ s T _ { 5 } ( x ) = \frac { 1 } { x } \text { for nonzero } x ^ { \prime } \mathrm { s } T 5 ( x ) = x 1 for nonzero x ′ s
解:
T 1 T_1 T 1 x 2 = 1 x^2=1 x 2 = 1 x 2 = − 1 x^2=−1 x 2 = − 1 T 4 T_4 T 4 e x = − 1 e^x=−1 e x = − 1 e x = b e^x=b e x = b x = ln b x = \ln b x = ln b
注意.T 5 2 = i d e n t i t y T_5^2=identity T 5 2 = i d e n t i t y T 3 2 = x + 18 T_3^2=x+18 T 3 2 = x + 18 T 2 , T 3 , T 3 T_2,T_3,T_3 T 2 , T 3 , T 3 x 3 = b , x + 9 = b , 1 / x = b x^3=b,x+9=b,1/x=b x 3 = b , x + 9 = b , 1/ x = b
x = T 2 − 1 ( b ) = b 1 / 3 x = T 3 − 1 ( b ) = b − 9 x = T 5 − 1 ( b ) = 1 / b x = T _ { 2 } ^ { - 1 } ( b ) = b ^ { 1 / 3 } \quad x = T _ { 3 } ^ { - 1 } ( b ) = b - 9 \quad x = T _ { 5 } ^ { - 1 } ( b ) = 1 / b x = T 2 − 1 ( b ) = b 1/3 x = T 3 − 1 ( b ) = b − 9 x = T 5 − 1 ( b ) = 1/ b
The Matrix of a Linear Transformation
综合V31后半部分
V31:理解线性变换,就是确定它背后的矩阵,这才是线性变换的本质 .为了做到这一点,我们需要引入坐标值,确定一组基 .下面开始讲解
假设有一个线性变换T,输入是3维向量,输出是2维向量,就是把三维空间的向量映射到二维空间,这可以轻易通过矩阵乘法实现.这时候A是一个2-3的矩阵.
> Start: T : R 3 → R 2 > Example: T ( v ) = A v > > \text{Start:} \quad T : R^3 \rightarrow R^2 \\
> \text{Example:} \quad T(v) = Av
> > Start: T : R 3 → R 2 > Example: T ( v ) = A v >
注意,上面的 T ( v ) = A v T(v) = Av T ( v ) = A v
Av的v是输入向量,3维的
整个T(v)是输出向量,2维的
线性变换对所有向量的意义不要通过1个个向量的看,应该见微知著,对整个向量空间线性变换 !而对于向量空间,只需要知道基向量 ,就能掌握一切,所以,只需要确定基向量 v 1 . . . v n v_1...v_n v 1 ... v n T ( v 1 ) . . . T ( v n ) T(v_1)...T(v_n) T ( v 1 ) ... T ( v n )
> v = c 1 v 1 + . . . + v n c n > (V1) > v = c_1v_1+...+v_nc_n \tag{V1}
> > v = c 1 v 1 + ... + v n c n > ( V1 )
从而根据线性化性质 ,我们一定有:
> T ( v ) = c 1 T ( v 1 ) + . . . + c n T ( v n ) > > T(v) = c_1T(v_1) +... +c_nT(v_n)
> > T ( v ) = c 1 T ( v 1 ) + ... + c n T ( v n ) >
现在问题是,如何把一个和坐标无关的线性变换变成一个与坐标有关的矩阵呢?矩阵源于坐标系,坐标的存在意味着,基已经被确立了!一旦选定了一组基,坐标也随着确定了,如 Eq(V1) 的 v 1 . . . v n v_1...v_n v 1 ... v n c 1 , c 2 . . . c n c_1,c_2...c_n c 1 , c 2 ... c n v ⃗ \vec{v} v 基向量的线性组合,就是向量唯一的表达式,系数就是坐标值.
坐标源于一组基(coordinates come from a basis)
在 Eq(V1) v ⃗ \vec{v} v c 1 . . . c n c_1...c_n c 1 ... c n v ⃗ \vec{v} v
一般来说,坐标系建立在标准基的基础上,所以平时你甚至不会意识到标准基的存在,v ⃗ = ( 3 , 2 , 4 ) \vec{v} = (3,2,4) v = ( 3 , 2 , 4 )
> v ⃗ = [ 3 2 4 ] = 3 [ 1 0 0 ] + 2 [ 0 1 0 ] + 4 [ 0 0 1 ] > > \vec{v} = \left[ \begin{array} { l } 3 \\ 2 \\ 4 \end{array} \right] = 3 \left[ \begin{array} { l } 1 \\ 0 \\ 0 \end{array} \right] + 2 \left[ \begin{array} { l } 0 \\1 \\ 0 \end{array} \right] + 4 \left[ \begin{array} { l } 0\\ 0 \\ 1 \end{array} \right]
> > v = 3 2 4 = 3 1 0 0 + 2 0 1 0 + 4 0 0 1 >
但你可以选择其他基,例如矩阵的特征向量也是一个很好的选择 ,然后坐标这有跟着基的改变而改变
现在我们希望通过矩阵描述线性变换:构造一个矩阵A,用于表示线性变换T,T可以是任何从n维到m维 T : R n → R m T:R^n \rightarrow R^m T : R n → R m
确定n维的输入空间一组输入基,以描述输入向量的坐标
确定m维的输出空间的一组输出基,以描述输出向量的坐标.
所以
令 v 1 . . . v n v_1...v_n v 1 ... v n R n R^n R n
令 w 1 . . . w m w_1...w_m w 1 ... w m R m R^m R m
**基已经确定,对应的矩阵也就确定,就可以引入坐标了!**怎么做呢?
首先选择一个向量v,通过输入基把它表示出来,于是得到它的坐标 c 1 . . . c n c_1...c_n c 1 ... c n
然后把这些坐标值 c 1 . . . c n c_1...c_n c 1 ... c n 坐标 !这个矩阵A的构造,就是<#2.1>!
根据上一节可知,任何线性变换 T 都对应一个矩阵,每一个不同的矩阵都对应于一个变换,矩阵乘以向量就代表一个线性变换 。输入v在 V = R n V = R^n V = R n W = R m W = R^m W = R m m-n 的.对V,W的基做出不同的选择,矩阵A是也会不一样 :
如果输出、输出的 R n , R m R^n,R^m R n , R m I 的列),那么A是标准矩阵,这时 T ( v ) = A v T(v) = Av T ( v ) = A v
但这些空间还有其他的基 ,所以同一个变换T就被其他矩阵所表示。每一种基的选择,都可以得到T的一个矩阵.当输入的基(input basis)不等于输出的基(output basis)时,T(v) = v 对应的矩阵A就不是单位矩阵I.它是"变基矩阵(change of basis matrix)"
sp:上句话的意思就是,T(v)= v是恒等变换,当基不同,矩阵A是变基矩阵。参见<#2.3>
线性代数的一个重要主题就是选择基,得到最好的代表T的矩阵
本节关键概念
假设我们对基向量 v 1 . . . v n v_1...v_n v 1 ... v n T ( v 1 ) . . . T ( v n ) T(v_1)...T(v_n) T ( v 1 ) ... T ( v n )
原因:任何向量v,都可以表达为基向量 v 1 . . . v n v_1...v_n v 1 ... v n 唯一 线性组合 c 1 v 1 + . . . + c n v n c_1v_1+...+c_nv_n c 1 v 1 + ... + c n v n v 的变换 T(v),肯定是已知的基向量变量 T ( v i ) T(v_i) T ( v i ) T ( v ) = c 1 T ( v 1 ) + . . . + c n T ( v n ) T(v) = c_1T(v_1)+...+c_nT(v_n) T ( v ) = c 1 T ( v 1 ) + ... + c n T ( v n )
例1. 标准基向量(1,0),(0,1)作为输入基时候的T(v)
假设T把 v 1 = ( 1 , 0 ) v_1=(1,0) v 1 = ( 1 , 0 ) T ( v 1 ) = ( 2 , 3 , 4 ) T(v_1)=(2,3,4) T ( v 1 ) = ( 2 , 3 , 4 )
而 v 2 = ( 0 , 1 ) v_2=(0,1) v 2 = ( 0 , 1 ) T ( v 2 ) = ( 5 , 5 , 5 ) T(v_2) = (5,5,5) T ( v 2 ) = ( 5 , 5 , 5 )
输出 T ( v 1 ) , T ( v 2 ) T(v_1),T(v_2) T ( v 1 ) , T ( v 2 ) R 2 R^2 R 2 R 3 R^3 R 3 3-2 的.并且,v = v 1 + v 2 v=v_1+v_2 v = v 1 + v 2 T ( v 1 ) + T ( v 2 ) T(v_1)+T(v_2) T ( v 1 ) + T ( v 2 ) 线性组合在线性变换后不变:
A = [ 2 5 3 5 4 5 ] . T ( v 1 + v 2 ) = T ( v 1 ) + T ( v 2 ) combines the columns [ 2 5 3 5 4 5 ] [ 1 1 ] = [ 7 8 9 ] A = \left[ \begin{array} { l l } 2 & 5 \\ 3 & 5 \\ 4 & 5 \end{array} \right] . \quad
\begin{array} { l } T \left( v _ { 1 } + v _ { 2 } \right) = T \left( v _ { 1 } \right) + T \left( v _ { 2 } \right) \\ \text { combines the columns } \end{array}
\quad
\left[ \begin{array} { l l } 2 & 5 \\ 3 & 5 \\ 4 & 5 \end{array} \right] \left[ \begin{array} { l } 1 \\ 1 \end{array} \right] = \left[ \begin{array} { l } 7 \\ 8 \\ 9 \end{array} \right] A = 2 3 4 5 5 5 . T ( v 1 + v 2 ) = T ( v 1 ) + T ( v 2 ) combines the columns 2 3 4 5 5 5 [ 1 1 ] = 7 8 9 例2+例V 介绍一个不一样的线性变换:求导 T = d d x T =\frac{d}{dx} T = d x d
输入是函数 c 1 + c 2 x + c 3 x 2 c_1+c_2x+c_3x^2 c 1 + c 2 x + c 3 x 2 1 , x , x 2 1,x,x^2 1 , x , x 2
输出是导数 c 2 + 2 c 3 x c_2+2c_3x c 2 + 2 c 3 x 1 , x 1,x 1 , x
我们看看矩阵A是什么(sp:其实A的求法需要在<#2.1>学习,下式是为了说明:一个函数(向量)的系数(基下的坐标),经过求导变换后,得到了求导结果的系数)
A [ c 1 c 2 c 3 ] = [ c 2 2 c 3 ] ⇒ [ 0 1 0 0 0 2 ] [ c 1 c 2 c 3 ] = [ c 2 2 c 3 ] A \left[ \begin{array} { l } c _ { 1 } \\ c _ { 2 } \\ c _ { 3 } \end{array} \right] = \left[ \begin{array} { l } c _ { 2 } \\ 2 c _ { 3 } \end{array} \right]
\Rightarrow\quad
\left[\begin{matrix} 0 & 1 & 0\\0 & 0 & 2\\\end{matrix} \right]
\left[ \begin{array} { l } c _ { 1 } \\ c _ { 2 } \\ c _ { 3 } \end{array} \right] = \left[ \begin{array} { l } c _ { 2 } \\ 2 c _ { 3 } \end{array} \right] A c 1 c 2 c 3 = [ c 2 2 c 3 ] ⇒ [ 0 0 1 0 0 2 ] c 1 c 2 c 3 = [ c 2 2 c 3 ] 这是一个三维空间到2维空间的线性变换. 不知你是否意识到求导是线性运算。我们之所以能够对函数求导,因为我们知道这是一个线性变换,只需要找我少量函数的求导法则,比如c o s x , s i n x , e x cosx,sinx,e^x cos x , s in x , e x
函数 1 , x , x 2 , x 3 1,x,x^2,x^3 1 , x , x 2 , x 3 0 , 1 , 2 x , 3 x 2 0,1,2x,3x^2 0 , 1 , 2 x , 3 x 2
T ( v ) = d v d x 遵循线性规则 d d x ( c v + d w ) = c d v d x + d d w d x . (1) T ( v ) = \frac { d v } { d x } \quad \text { 遵循线性规则 } \quad \frac { d } { d x } ( c v + d w ) = c \frac { d v } { d x } + d \frac { d w } { d x } .
\tag{1} T ( v ) = d x d v 遵循线性规则 d x d ( c v + d w ) = c d x d v + d d x d w . ( 1 ) 就是因为这个线性关系,所以才能够找到其他所有函数的导数.根据每一个不同幂的函数 1 , x , x 2 , x 3 1,x,x^2,x^3 1 , x , x 2 , x 3 v 1 , v 2 , v 3 , v 4 v_1,v_2,v_3,v_4 v 1 , v 2 , v 3 , v 4 4 + x + x 2 + x 3 4+x+x^2+ x^3 4 + x + x 2 + x 3
d d x ( 4 + x + x 2 + x 3 ) = 1 + 2 x + 3 x 2 because of linearity! \frac { d } { d x } \left( 4 + x + x ^ { 2 } + x ^ { 3 } \right) = 1 + 2 x + 3 x ^ { 2 } \quad \quad \color{orange} \text{because of linearity!} d x d ( 4 + x + x 2 + x 3 ) = 1 + 2 x + 3 x 2 because of linearity! 上式,把T变换(求导d/dx)应用到输入 v = 4 v 1 + v 2 + v 3 + v 4 v = 4v_1+v_2+v_3+v_4 v = 4 v 1 + v 2 + v 3 + v 4 1 , x , x 2 , x 3 1,x,x^2,x^3 1 , x , x 2 , x 3 所有组合 .你可能会叫他们函数,但我称它们为向量! 这4个向量是3次多项式(cubic polunomials,degree <=3) 空间V的基.只要这四个基向量的导数,我们可以知道V中的全部导数
为了求矩阵A的零空间,我们求解 Av = 0.为了得到求导变换T的内核,我们求解 dv/dx = 0.解是 v=constant,所以T的零空间是一维的,包含所有的常数函数(比如第一个基函数 v 1 = 1 v_1=1 v 1 = 1
为了找到值域(其实就是列空间),看看输出 T ( v ) = d v / d x T(v) = dv/dx T ( v ) = d v / d x a + b x + c x 2 + d x 3 a+bx+cx^2+dx^3 a + b x + c x 2 + d x 3
如果设 W=cubics,那么T的值域(the quadratics)是W的子空间
如果设 w=quadratics,那么值域就是整个W
sp:这里的意思就是:输出空间 W 可以比 变换T的输出结果,也就是值域大,不是值域定义输出空间,值域是包含在输出空间W的。
注意如上的第2个选择,强调了定义域,也就是输入空间(V=cubics)和输出空间(W=quadraticcs)之间的不同.V的维数是4,W的维数是3.这个导数矩阵应该是3-4的
T的值域是一个3维子空间,所以矩阵的秩将会是r = 3.而内核是1维的.和3+1= 4是输入空间的维数.其实这就是r+(n-r)=n,线性代数的基础定理.总有:
(dimension of range) + (dimension of kernel) = dimension of input space \text{(dimension of range) + (dimension of kernel) = dimension of input space} (dimension of range) + (dimension of kernel) = dimension of input space
sp-note7.2-3:真神奇啊。注意
列空间维数+零空间维数=n!这里的n,表示 R n R^n R n R n R^n R n
导数变换把3次的空间V变换成2次的空间W.V的基是 1 , x , x 2 , x 3 1,x,x^2,x^3 1 , x , x 2 , x 3 1 , x , x 2 1,x,x^2 1 , x , x 2
A = [ 0 1 0 0 0 0 2 0 0 0 0 3 ] = matrix form of derivative T (2) A = \left[ \begin{array} { l l l l } 0 & 1 & 0 & 0 \\ 0 & 0 & 2 & 0 \\ 0 & 0 & 0 & 3 \end{array} \right] = \text { matrix form of derivative } T \tag{2} A = 0 0 0 1 0 0 0 2 0 0 0 3 = matrix form of derivative T ( 2 ) 为什么A是正确的呢?因为乘以A和T做的变换是吻合的 .v = a + b x + c x 2 + d x 3 v= a+bx+cx^2+dx^3 v = a + b x + c x 2 + d x 3 T ( v ) = b + 2 c x + 3 d x 2 T(v) = b+2cx+3dx^2 T ( v ) = b + 2 c x + 3 d x 2
求导 [ 0 1 0 0 0 0 2 0 0 0 0 3 ] [ a b c d ] = [ b 2 c 3 d ] (3) \text{求导}\quad
\left[ \begin{array} { l l l l } 0 & 1 & 0 & 0 \\ 0 & 0 & 2 & 0 \\ 0 & 0 & 0 & 3 \end{array} \right] \left[ \begin{array} { l } a \\ b \\ c \\ d \end{array} \right] = \left[ \begin{array} { c } b \\ 2 c \\ 3 d \end{array} \right]
\tag{3} 求导 0 0 0 1 0 0 0 2 0 0 0 3 a b c d = b 2 c 3 d ( 3 ) 例3. 积分是导数的逆,这是微积分基础定理。我们现在可以在线代看到这个定理!在 0-x 区间积分 对应的 变换 T − 1 T^{−1} T − 1 T − 1 T^{−1} T − 1 1 , x , x 2 1,x,x^2 1 , x , x 2 w 1 , w 2 , w 3 w_1,w_2,w_3 w 1 , w 2 , w 3
积分是 T − 1 : ∫ 0 x 1 d x = x , ∫ 0 x x d x = 1 2 x 2 , ∫ 0 x x 2 d x = 1 3 x 3 \text{积分是}T ^ { - 1 }: \quad \int _ { 0 } ^ { x } 1 d x = x , \quad \int _ { 0 } ^ { x } x d x = \frac { 1 } { 2 } x ^ { 2 } , \quad \int _ { 0 } ^ { x } x ^ { 2 } d x = \frac { 1 } { 3 } x ^ { 3 } 积分是 T − 1 : ∫ 0 x 1 d x = x , ∫ 0 x x d x = 2 1 x 2 , ∫ 0 x x 2 d x = 3 1 x 3 根据线性化,对 w = B + C x + D x 2 w = B+Cx+Dx^2 w = B + C x + D x 2 T − 1 ( w ) = B x + 1 / 2 C x 2 + 1 / 3 D x 3 T^{−1} (w)=Bx+1/2 Cx^2+1/3 Dx^3 T − 1 ( w ) = B x + 1/2 C x 2 + 1/3 D x 3 矩阵应该是4-3的
T − 1 T^{-1} T − 1 T − 1 ( w ) = B x + 1 / 2 C x 2 + 1 / 3 D x 3 T^{−1} (w)=Bx+1/2 Cx^2+1/3 Dx^3 T − 1 ( w ) = B x + 1/2 C x 2 + 1/3 D x 3 T − 1 T^{-1} T − 1 Z = { 0 } Z= \{0\} Z = { 0 }
线代基础定理:3+0 =3 是 T − 1 T^{-1} T − 1
再看看 T − 1 T^{−1} T − 1 w = B + C x + D x 2 w = B+Cx+Dx^2 w = B + C x + D x 2 0 + B x + 1 / 2 C x 2 + 1 / 3 D x 3 0 +Bx + 1/2Cx^2+1/3Dx^3 0 + B x + 1/2 C x 2 + 1/3 D x 3
sp:现在要被变换的"V"的基是 1 , x , x 2 1,x,x^2 1 , x , x 2 1 , x , x 2 , x 3 1,x,x^2,x^3 1 , x , x 2 , x 3
积分 [ 0 0 0 1 0 0 0 1 2 0 0 0 1 3 ] [ B C D ] = [ 0 B 1 2 C 1 3 D ] (4) \text{积分} \quad
\left[ \begin{array} { c c c } 0 & 0 & 0 \\ 1 & 0 & 0 \\ 0 & \frac { 1 } { 2 } & 0 \\ 0 & 0 & \frac { 1 } { 3 } \end{array} \right] \left[ \begin{array} { c } B \\ C \\ D \end{array} \right] = \left[ \begin{array} { r } 0 \\ B \\ \frac { 1 } { 2 } C \\ \frac { 1 } { 3 } D \end{array} \right]
\tag{4} 积分 0 1 0 0 0 0 2 1 0 0 0 0 3 1 B C D = 0 B 2 1 C 3 1 D ( 4 ) 我想把 Eq(4) 矩阵的称为 A − 1 A^{−1} A − 1
A A − 1 = [ 1 0 0 0 1 0 0 0 1 ] 但 A − 1 A = [ 0 0 0 0 0 1 0 0 0 0 1 0 0 0 0 1 ] A A ^ { - 1 } = \left[ \begin{array} { l l l } 1 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & 0 & 1 \end{array} \right] \quad \text { 但 } \quad A ^ { - 1 } A = \left[ \begin{array} { l l l l } 0 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{array} \right] A A − 1 = 1 0 0 0 1 0 0 0 1 但 A − 1 A = 0 0 0 0 0 1 0 0 0 0 1 0 0 0 0 1
sp:matlab可以用 pinv 得到伪逆,在列满秩的情况下就是左逆啊,所以上式好像把顺序写反了...
如果你先积分一个函数然后求导,你回到原点,也就是 A A − 1 = I AA^{−1}=I A A − 1 = I 对1的导数的积分是0:
T − 1 T ( 1 ) = integral of zero function = 0 T^{-1}T(1) = \text{integral of zero function } = 0 T − 1 T ( 1 ) = integral of zero function = 0 这也吻合 A − 1 A A^{−1} A A − 1 A 导数T有内核(也就是常数函数),所以它对应的矩阵A有零空间.
Construction of the matrix
现在我们对任何线性变换构建矩阵A.
假设 T 把空间V(n维的) 变换到 空间W(m维的).对V的基的选择是 v 1 , … v n v_1,…v_n v 1 , … v n w 1 … w m w_1…w_m w 1 … w m v 1 v_1 v 1 T ( v 1 ) T(v_1) T ( v 1 )
T ( v 1 ) T(v_1) T ( v 1 ) a 11 w 1 + . . . + a m 1 w m a_{11}{w_1}+...+a_{m1}w_m a 11 w 1 + ... + a m 1 w m v 1 v_1 v 1 a 11 … a m 1 a_{11}…a_{m1} a 11 … a m 1 v 1 v_1 v 1 T ( v 1 ) T(v_1) T ( v 1 ) (1,0...0) 是匹配的s p − M a r k 7.2 − 1 ^{sp-Mark7.2-1} s p − M a r k 7.2 − 1
理解<sp-Mark7.2-1> (来自V):假设输入是第1个基 v 1 = ( 1...0 ) v_1 = (1...0) v 1 = ( 1...0 ) a 11 , a 21 . . . a m 1 a_{11},a_{21}...a_{m1} a 11 , a 21 ... a m 1 T ( v 1 ) T(v_1) T ( v 1 )
构建A的关键规则 就是: A的第 j 列,是通过 把 T 应用到 V的 第 j 个基向量 v j v_j v j
> T ( v j ) = W 基向量的线性组合 = a 1 j w 1 + . . . . + a m j w m > > (5) > T(v_j) = \text{W 基向量的线性组合} = a_{1j}w_1 + ....+a_{mj}w_m
> \tag{5}
> > T ( v j ) = W 基向量的线性组合 = a 1 j w 1 + .... + a mj w m >> ( 5 )
sp:应该这样理解:已经知道 T ( v j ) T(v_j) T ( v j )
a 1 j … a m j a_{1j}…a_{mj} a 1 j … a mj j 列.这样构造出来的矩阵A,能正确表示V的基向量,从而线性化让所有V空间下的向量都是正确的(The matrix is constructed to get the basis vector right,Then linearity gets all the other vectors right) .
V下的每一个v都是基向量的组合: c 1 v 1 + … + c n v n c_1 v_1+…+c_n v_n c 1 v 1 + … + c n v n T(v)是W的基 w's 的组合 .当A乘以v向量在V空间下的系数向量(cofficients vector,也就是坐标) c = ( c 1 … c n ) c = (c_1…c_n) c = ( c 1 … c n ) T(v) 在W的基下组合的系数,也就是T(v) 在W空间下的坐标!这是因为矩阵乘法(列的线性组合)和T一样是线性的.
矩阵A告诉我们T做了什么.每一个从V到W的线性变换都可以转换成矩阵.而且这个矩阵取决于基.
总结(来自V):确定线性变换的矩阵A呢?
1 首先确定两组基,输入基 v1...vn,和输出基 w1...wm
2 然后确定A的第一列,怎么做呢?最直接的方法是,对输入v1进行线性变换,写出输出T(v1),并把T(v1)写成是 w1...wm 的组合,线性组合的系数就是矩阵的第一列
> T ( v 1 ) = a 11 w 1 + a 21 w 2 + . . . + a m 1 w m > > T(v_1) = a_{11}w_1+a_{21}w_2 + ... + a_{m1}w_m
> > T ( v 1 ) = a 11 w 1 + a 21 w 2 + ... + a m 1 w m >
上式的 a 11 , a 21 . . . a m 1 a_{11},a_{21}...a_{m1} a 11 , a 21 ... a m 1
3 矩阵的第2列和第2步一样,只不过这次换成 v2进行步骤
> T ( v 2 ) = a 12 w 1 + a 22 w 2 + . . . + a m 2 w m > > T(v_2) = a_{12}w_1+a_{22}w_2 + ... + a_{m2}w_m
> > T ( v 2 ) = a 12 w 1 + a 22 w 2 + ... + a m 2 w m >
上式的 a 12 , a 22 . . . a m 2 a_{12},a_{22}...a_{m2} a 12 , a 22 ... a m 2
如:
在例2,T是求导变换,V的第一个基向量是1,它的导数是 T ( v 1 ) = 0 T(v_1) = 0 T ( v 1 ) = 0
在例3,T − 1 T^{-1} T − 1 A − 1 A^{−1} A − 1 ( 0 , 1 , 0 , 0 ) . (0,1,0,0). ( 0 , 1 , 0 , 0 ) .
理解 :A的列j,是把V的基 v j v_j v j v 1 . . . v n v_1...v_n v 1 ... v n v = c 1 v 1 + . . . + c n v n v= c_1v_1 + ...+c_nv_n v = c 1 v 1 + ... + c n v n 线性 变换,所以T(v)还是这样组合的!也就是 T ( v ) = c 1 T ( v 1 ) + . . . + c n T ( v n ) T(v)= c_1T(v_1) + ...+c_nT(v_n) T ( v ) = c 1 T ( v 1 ) + ... + c n T ( v n )
证明 :设v在V的基下的坐标是( c 1 , . . . , c n ) (c_1,...,c_n) ( c 1 , ... , c n )
> v = [ v 1 , . . . , v n ] [ c 1 ⋮ c n ] > (S1) > v = [v_1,...,v_n] \left[\begin{matrix}c_1\\\vdots\\c_n\\ \end{matrix} \right] \tag{S1}
> > v = [ v 1 , ... , v n ] c 1 ⋮ c n > ( S1 )
T(v) 在W的基的坐标是 ( b 1 . . . b m ) (b_1...b_m) ( b 1 ... b m )
> T ( v ) = [ w 1 , . . . , v m ] [ b 1 ⋮ b m ] > (S2) > T(v) = [w_1,...,v_m] \left[\begin{matrix}b_1\\\vdots\\b_m\\ \end{matrix} \right] \tag{S2}
> > T ( v ) = [ w 1 , ... , v m ] b 1 ⋮ b m > ( S2 )
Ac乘法,得到的就是 T(v) 在W空间下的坐标
> [ a 11 … a 1 n ⋮ … ⋮ a m 1 … a m n ] > [ c 1 ⋮ c n ] > = [ b 1 ⋮ b m ] > (S3) > \left[\begin{matrix} a_{11} & \dots & a_{1n}\\ \vdots & \dots & \vdots\\ a_{m1} & \dots & a_{mn}\\\end{matrix} \right]
> \left[\begin{matrix}c_1\\\vdots\\c_n\\ \end{matrix} \right]
> = \left[\begin{matrix}b_1\\\vdots\\b_m\\ \end{matrix} \right] \tag{S3}
> > a 11 ⋮ a m 1 … … … a 1 n ⋮ a mn > c 1 ⋮ c n >= b 1 ⋮ b m > ( S3 )
也就是说:
矩阵A是通过,将V的 n 个基的T变换,用W的基来表示,从而得到A的n个列。A的第1列就是第1个基 v 1 v_1 v 1 T ( v 1 ) T(v_1) T ( v 1 ) v n v_n v n T ( v n ) T(v_n) T ( v n )
因为已经将V的基的T变换,成功用W基的线性组合表示,所以任何v的变换 T ( v ) T(v) T ( v ) (Eq(S3)为何成立?参见Eq(S7)!)矩阵A的作用是:在V的==一组基== v 1 . . . v n v_1...v_n v 1 ... v n ( c 1 . . . c n ) (c_1...c_n) ( c 1 ... c n ) ( w 1 . . . w m ) (w_1...w_m) ( w 1 ... w m ) ( b 1 . . . b m ) (b_1...b_m) ( b 1 ... b m ) .所以,T变化(A矩阵)是取决于V,W的基的,只要选择的基不同,A矩阵就不同.
证明Eq(S3) 先不要管矩阵乘法 Av,只看变换结果 T ( v i ) T(v_i) T ( v i ) T ( v 1 ) T(v_1) T ( v 1 ) R m R^m R m R m R^m R m i 列,分别对 V 空间的第 i 个基向量应用上述过程,得到
> T ( v i ) = a 1 i w 1 + . . . + a m i w m = ∑ j = 1 m a j i w j > (S4) > T(v_i)= a_{1i}{w_1}+...+a_{mi}w_m = \sum_{j=1}^m a_{ji}w_j \tag{S4}
> > T ( v i ) = a 1 i w 1 + ... + a mi w m = j = 1 ∑ m a j i w j > ( S4 )
从而,A矩阵是如下的系数矩阵:
> A = [ a 11 … a 1 n ⋮ … ⋮ a m 1 … a m n ] > > A= \left[\begin{matrix} a_{11} & \dots & a_{1n}\\ \vdots & \dots & \vdots\\ a_{m1} & \dots & a_{mn}\\\end{matrix} \right]
> > A = a 11 ⋮ a m 1 … … … a 1 n ⋮ a mn >
那么:
> T [ ∣ . . . ∣ v 1 . . . v n ∣ . . . ∣ ] > = [ ∣ . . . ∣ T ( v 1 ) . . . T ( v n ) ∣ . . . ∣ ] > = [ ∣ . . . ∣ w 1 . . . w m ∣ . . . ∣ ] ∗ [ a 11 … a 1 n ⋮ … ⋮ a m 1 … a m n ] = W的基*矩阵A! > > (S8) > T\left[\begin{matrix} | & ... & |\\v_1 & ... & v_n\\| & ... & |\\\end{matrix} \right]
> = \left[\begin{matrix} | & ... & |\\T(v_1) & ... & T(v_n)\\| & ... & |\\\end{matrix} \right]
> = \left[\begin{matrix} | & ... & |\\w_1 & ... & w_m\\| & ... & |\\\end{matrix} \right] * \left[\begin{matrix} a_{11} & \dots & a_{1n}\\ \vdots & \dots & \vdots\\ a_{m1} & \dots & a_{mn}\\\end{matrix} \right] = \color{orange} \text{W的基*矩阵A!}
> \tag{S8}
> > T ∣ v 1 ∣ ... ... ... ∣ v n ∣ >= ∣ T ( v 1 ) ∣ ... ... ... ∣ T ( v n ) ∣ >= ∣ w 1 ∣ ... ... ... ∣ w m ∣ ∗ a 11 ⋮ a m 1 … … … a 1 n ⋮ a mn = W 的基 * 矩阵 A ! >> ( S8 )
v 1 . . . v n v_1...v_n v 1 ... v n V的基 ,也就说,将T对V的基的变换,用W的基线性组合的来表示,从而得到矩阵A。
参见 Eq(S1,S2),v在V空间的坐标是 ( c 1 . . . c n ) (c_1...c_n) ( c 1 ... c n ) ( b 1 . . . b m ) (b_1...b_m) ( b 1 ... b m )
> T ( v ) = T ( ∑ i = 1 n c i v i ) = ∑ i = 1 n c i T ( v i ) = c 1 T ( v 1 ) + ⋯ + c n T ( v n ) = > [ T ( v 1 ) … T ( v n ) ] > [ c 1 c 2 … c n ] > > (S5) > \mathrm { T } ( \mathrm { v } ) = \mathrm { T } \left( \sum _ { i = 1 } ^ { n } c _ { i } v _ { \mathrm { i } } \right) = \sum _ { i = 1 } ^ { n } c _ { \mathrm { i } } T \left( v _ { \mathrm { i } } \right) = c _ { 1 } T \left( v _ { 1 } \right) + \cdots + c _ { \mathrm { n } } T \left( v _ { n } \right) =
> \left[ T \left( v _ { 1 } \right) \ldots T \left( v _ { n } \right) \right]
> \left[ \begin{array} { c } c _ { 1 } \\ c _ { 2 } \\ \ldots \\ c _ { n } \end{array} \right]
> \tag{S5}
> > T ( v ) = T ( i = 1 ∑ n c i v i ) = i = 1 ∑ n c i T ( v i ) = c 1 T ( v 1 ) + ⋯ + c n T ( v n ) => [ T ( v 1 ) … T ( v n ) ] > c 1 c 2 … c n >> ( S5 )
将 T ( v i ) T(v_i) T ( v i )
> > T ( v ) = ∑ i = 1 n c i ( ∑ j = 1 m a j i w j ) = > > > c 1 [ a 11 w 1 + . . . + a m 1 w m ] > + > ⋮ > + > c n [ a 1 n w 1 + . . . + a m n w m ] > > > > = > w 1 [ c 1 a 11 + . . . + c n a 1 n ] + > + > ⋮ > + > w m [ c 1 a m 1 + . . . + c n a m n ] > > > > > > = ∑ j = 1 m ( ∑ i = 1 n c i a j i ) w j > = [ w 1 . . . w m ] [ ∑ i = 1 n c i a 1 i ⋮ ∑ i = 1 n c i a m i ] > > > > (S6) > \begin{aligned}
> T(v) & = \sum _ { i = 1 } ^ { n } c _ { i } \left( \sum _ { j = 1 } ^ { m } a _ { j i } w _ { \mathrm { j } } \right) =
>
> \begin{aligned}
> &c_1[a_{11}w_1 + ... + a_{m1}w_m] \\
> &+ \\
> &\vdots\\
> &+ \\
> & c_n[a_{1n}w_1 + ... + a_{mn}w_m]
>
> \end{aligned}
>
> = \begin{aligned}
> & w_1[c_1 a_{11} + ... + c_n a_{1n}] + \\
> &+ \\
> &\vdots\\
> &+ \\
> &w_m[c_1a_{m1} + ... + c_n a_{mn}]
>
> \end{aligned}
>
> \\[4ex]
>
> &= \sum _ { j = 1 } ^ { m } \left( \sum _ { i = 1 } ^ { n } c _ { i } a _ { j i } \right) w _ { j }
> = [w_1...w_m]\left[\begin{matrix} \sum _ { i = 1 } ^ { n }c_i a_{1i} \\\vdots\\ \sum _ { i = 1 } ^ { n }c_ia_{mi} \\ \end{matrix} \right]
> \end{aligned}
>
> \tag{S6}
> > > T ( v ) >> = i = 1 ∑ n c i ( j = 1 ∑ m a j i w j ) =>> > > > > > c 1 [ a 11 w 1 + ... + a m 1 w m ] + ⋮ + c n [ a 1 n w 1 + ... + a mn w m ] >> >>= > > > > > w 1 [ c 1 a 11 + ... + c n a 1 n ] + + ⋮ + w m [ c 1 a m 1 + ... + c n a mn ] >> >> = j = 1 ∑ m ( i = 1 ∑ n c i a j i ) w j >= [ w 1 ... w m ] ∑ i = 1 n c i a 1 i ⋮ ∑ i = 1 n c i a mi > >>> ( S6 )
因为 w 1 . . . w m w_1...w_m w 1 ... w m Eq(S3) 的基坐标 ( b 1 . . b m ) (b_1..b_m) ( b 1 .. b m ) [ w 1 . . . w m ] [w_1...w_m] [ w 1 ... w m ]
> [ b 1 ⋮ b m ] = [ ∑ i = 1 n c i a 1 i ⋮ ∑ i = 1 n c i a m i ] = > > [ a 11 … a 1 n ⋮ … ⋮ a m 1 … a m n ] [ c 1 ⋮ c n ] = > > A c > (S7) > \left[\begin{matrix}b_1\\\vdots\\b_m\\ \end{matrix} \right] = \left[\begin{matrix} \sum _ { i = 1 } ^ { n }c_i a_{1i} \\\vdots\\ \sum _ { i = 1 } ^ { n }c_ia_{mi} \\ \end{matrix} \right] =
>
> \left[\begin{matrix} a_{11} & \dots & a_{1n}\\ \vdots & \dots & \vdots\\ a_{m1} & \dots & a_{mn}\\\end{matrix} \right]\left[\begin{matrix}c_1\\\vdots\\c_n\\ \end{matrix} \right] =
>
> Ac \tag{S7}
> > b 1 ⋮ b m = ∑ i = 1 n c i a 1 i ⋮ ∑ i = 1 n c i a mi =>> a 11 ⋮ a m 1 … … … a 1 n ⋮ a mn c 1 ⋮ c n =>> A c > ( S7 )
得证!(sp:,其实<#Lk1> Eq(K3) 就是Eq(S7)的特殊形式啊)
例4. 如果基改变了,T还是相同的变换,但是矩阵A改变了
在例2当中,假设对 V 当中的3次多项式的重新排列基为 x , x 2 , x 3 , 1 x,x^2,x^3,1 x , x 2 , x 3 , 1 1 , x , x 2 1,x,x^2 1 , x , x 2 v 1 = x v_1 =x v 1 = x w 1 = 1 w_1=1 w 1 = 1 Eq(1) 的A对比,现在的A的第一列是不一样的:
A new = [ 1 0 0 0 0 2 0 0 0 0 3 0 ] A _ { \text {new } } = \left[ \begin{array} { l l l l } 1 & 0 & 0 & 0 \\ 0 & 2 & 0 & 0 \\ 0 & 0 & 3 & 0 \end{array} \right] A new = 1 0 0 0 2 0 0 0 3 0 0 0 当我们重新排列了V的基,我们重新排列了A的列 .
输入基向量 v j v_j v j
而输出基向量 w i w_i w i i 行负责的
稍后我们会看到,基的改变,不仅仅只是排列顺序改变而已
Products AB Match Transformations TS
求导和积分的例子有3点需要注意
线性变换T存在于任何地方-微积分,微分方程和线性代数.
不仅仅是 R n R^n R n
T可以用一个矩阵A表示.
下一个例子当中,V=W.而且对2个空间都选择一样的基,然后我们可以比较一下矩阵 A 2 , A B A^2,AB A 2 , A B T 2 , T S T^2,TS T 2 , T S
例5(旋转). T旋转每一个向量角度θ,这里,V = W = R 2 V = W= R^2 V = W = R 2 (1,0),(0,1)
解:V,W标准基是 v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) . v_1=(1,0),v_2=(0,1). v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) . ( c o s θ , s i n θ ) (cosθ,sinθ) ( cos θ , s in θ ) c o s θ ∗ ( 1 , 0 ) cosθ*(1,0) cos θ ∗ ( 1 , 0 ) s i n θ ∗ ( 0 , 1 ) sinθ*(0,1) s in θ ∗ ( 0 , 1 ) c o s θ , s i n θ cosθ,sinθ cos θ , s in θ [ cos θ sin θ ] \left[ \begin{array} { c } \cos \theta \\ \sin \theta \end{array} \right] [ cos θ sin θ ] A = [ cos θ − sin θ sin θ cos θ ] A = \left[ \begin{array} { r r } \cos \theta & - \sin \theta \\ \sin \theta & \cos \theta \end{array} \right] A = [ cos θ sin θ − sin θ cos θ ]
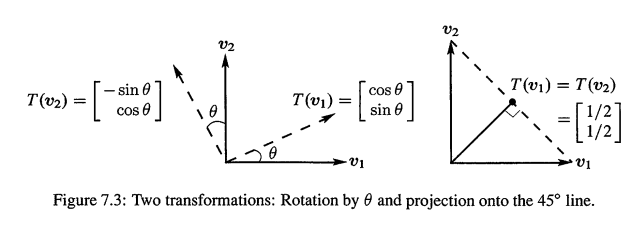
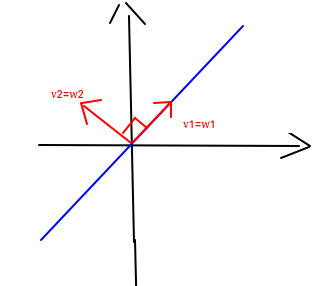
例6(投影,结合V31的例子). 假设T把每一个平面向量投影到45度直线(下图蓝色直线).找到这个投影的2组不同的基对应的矩阵.
解:
1 特征向量为基: 从特殊的基开始,并且输入基=输出基:
假设基向量 v 1 v_1 v 1 T ( v 1 ) = v 1 T(v_1) = v_1 T ( v 1 ) = v 1
第2个基向量 v 2 v_2 v 2 135 ∘ 135^{\circ} 13 5 ∘
现在问题是,这个矩阵是什么?我们知道,任意向量v,都可以表示成基向量的组合 v = c 1 v 1 + c 2 v 2 v = c_1v_1+c_2v_2 v = c 1 v 1 + c 2 v 2 ( c 1 , c 2 ) (c_1,c_2) ( c 1 , c 2 ) 注意T(v)要表示成输入基的组合 ,在这里也就是等数输入基的输出基 w 1 , w 2 w_1,w_2 w 1 , w 2
观察 v = c 1 v 1 + c 2 v 2 v = c_1v_1+c_2v_2 v = c 1 v 1 + c 2 v 2 变换对输入基 v 1 , v 2 v_1,v_2 v 1 , v 2
当输入为基向量v 1 v_1 v 1 T ( v 1 ) T(v_1) T ( v 1 ) v 1 v_1 v 1
如果输入是第2个基向量 v 2 v_2 v 2
所以,对于任何 v = c 1 v 1 + c 2 v 2 v = c_1v_1+c_2v_2 v = c 1 v 1 + c 2 v 2 c 1 v 1 c_1v_1 c 1 v 1 c 2 v 2 c_2v_2 c 2 v 2
T ( v ) = T ( c 1 v 1 + c 2 v 2 ) = c 1 T ( v 1 ) + c 2 T ( v 2 ) = c 1 v 1 T(v) = T(c_1v_1+c_2v_2) = c_1T(v_1)+c_2T(v_2) = c_1v_1 T ( v ) = T ( c 1 v 1 + c 2 v 2 ) = c 1 T ( v 1 ) + c 2 T ( v 2 ) = c 1 v 1 现在我们看看代表这个变换的矩阵是什么。这个矩阵的作用就是:输入 [ c 1 , c 2 ] [c_1,c_2] [ c 1 , c 2 ] [ c 1 , 0 ] [c_1,0] [ c 1 , 0 ]
sp:矩阵是对坐标 起作用!
[ 1 0 0 0 ] ⏟ A [ c 1 c 2 ] ⏟ input coords = [ c 1 0 ] ⏟ output coords (V2) \underbrace{\left[ \begin{array} { l l } 1 & 0 \\ 0 & 0 \end{array} \right] }_{A}
\underbrace{\left[ \begin{array} { l } c _ { 1 } \\ c _ { 2 } \end{array} \right] }_{\quad \color{orange} \text{input coords}}
=
\underbrace{\left[ \begin{array} { c } c _ { 1 } \\ 0 \end{array} \right]}_{\quad \color{orange} \text{output coords}}
\tag{V2} A [ 1 0 0 0 ] input coords [ c 1 c 2 ] = output coords [ c 1 0 ] ( V2 ) 这里需要强调2点
首先,矩阵起到了应有的作用。原来的线性变换是不涉及到坐标值的。现在有了矩阵,这个矩阵,正确的通过输入坐标,得到输出坐标!
在这个例子里,输入和输出空间使用了同一组基 ,实际上这组基都是投影的特征向量 .所以得到的矩阵是对角矩阵 Λ \Lambda Λ ,这组基很好.因为,如果以特征向量为基,可以得到对角阵,对角线上都是特征值 .这是物理学家的最爱,他们不情愿地引入坐标系,而最好的坐标系有特征向量构成.
2 选择标准基作为输入和输出空间的基 : (1,0),(0,1) .Fig7.3右边展示了 (1,0) 投影成 (1/2,1/2),这就得到了A的第一列.而另外一个基向量也同样成(1/2,1/2),所以这个标准的矩阵是:
A = [ 1 2 1 2 1 2 1 2 ] Same prjection for the standard basis A = \left[ \begin{array} { c c } \frac { 1 } { 2 } & \frac { 1 } { 2 } \\ \frac { 1 } { 2 } & \frac { 1 } { 2 } \end{array} \right] \quad \quad \color{orange} \text{Same prjection for the standard basis} A = [ 2 1 2 1 2 1 2 1 ] Same prjection for the standard basis 这其实就是投影矩阵,可以如下求得(a是代表投影直线的向量,如 ( 1 , 1 ) (1,1) ( 1 , 1 )
A = a a T a T a = [ 1 2 1 2 1 2 1 2 ] A = \frac { a a ^ { T } } { a ^ { T } a } = \left[ \begin{array} { l } \frac { 1 } { 2 } \frac { 1 } { 2 } \\ \frac { 1 } { 2 } \frac { 1 } { 2 } \end{array} \right] A = a T a a a T = [ 2 1 2 1 2 1 2 1 ] 但矩阵不是对角矩阵,因为基不是最佳的基.但是也不算太差,是一个对称矩阵,满足 P 2 = P P^2 = P P 2 = P
总结: 2个A都是投影矩阵.你平方A的话是没有改变的.注意这句话背后隐藏的意思: T 2 T^2 T 2 A 2 A^2 A 2
sp-Note-7.2.6:以特征向量为基的变换矩阵是简单很多,参见 <#LK1.4> ,还有<V31总结>
我们必须思考一个重要的事情--矩阵为何这样相乘的真正原因.设
当对 S 的输出应用 T ,得到的是复合(composition) 的TS.当我们在B之后应用A,得到的是乘积AB.矩阵乘法给出了表示TS的正确矩阵AB
变换S是从空间U到V,在U中,它的矩阵B使用的是 U 的基 u 1 , u 2 … u p u_1,u_2…u_p u 1 , u 2 … u p v 1 … v n v_1…v_n v 1 … v n
变换T是从V到W的.它的矩阵A使用的必须是一样的V的基 v 1 … v n v_1…v_n v 1 … v n
也就是说,S输出了V空间的一组基 ,同时,T的输入空间必须是V空间 ,并且恰好是V空间的这组基 。 这时候,AB和TS是匹配的.
Multiplication
线性变换 TS 是
从空间 U 当中的任何向量 u 开始,变换其到空间 V 当中的向量 S(u)
然后 T(S(u)) 变换空间 V 的向量 S(u) 到空间 W
而矩阵乘法 AB,从任何 R p R^p R p R n R^n R n R m R^m R m 矩阵乘法AB代表了变换TS :
> T S : U → V → W A B : ( m by n ) ( n by p ) = ( m by p ) . > > TS:\quad U \rightarrow V\rightarrow W \qquad \qquad A B : ( m \text { by } n ) ( n \text { by } p ) = ( m \text { by } p ) .
> > T S : U → V → W A B : ( m by n ) ( n by p ) = ( m by p ) . >
最开始的输入向量是 u = x 1 u 1 + . . . + x p u p u = x_1u_1+...+x_pu_p u = x 1 u 1 + ... + x p u p A B x ABx A B x Product of transformations matches product of matrices.
最重要的情况是,当U,V,W是同1个空间,并且拥有相同的一组基 。此时 m=n=p,矩阵都是方阵!
例7. S旋转角度θ,T也是旋转θ,那么TS旋转2θ,变换 T 2 T^2 T 2 A 2 A^2 A 2
T = S A = B T 2 = rotation by 2 θ A 2 = [ cos 2 θ − sin 2 θ sin 2 θ cos 2 θ ] (6) T = S \quad A = B \quad T ^ { 2 } = \text { rotation by } 2 \theta \quad A ^ { 2 } = \left[ \begin{array} { c r } \cos 2 \theta & - \sin 2 \theta \\ \sin 2 \theta & \cos 2 \theta \end{array} \right]
\tag{6} T = S A = B T 2 = rotation by 2 θ A 2 = [ cos 2 θ sin 2 θ − sin 2 θ cos 2 θ ] ( 6 ) 通过这个 ( 变换 ) 2 = ( 矩阵 ) 2 (变换)^2= (矩阵)^2 ( 变换 ) 2 = ( 矩阵 ) 2
[ cos θ − sin θ sin θ cos θ ] [ cos θ − sin θ sin θ cos θ ] = [ cos 2 θ − sin 2 θ − 2 sin θ cos θ 2 sin θ cos θ cos 2 θ − sin 2 θ ] (7) \left[ \begin{array} { r r } \cos \theta & - \sin \theta \\ \sin \theta & \cos \theta \end{array} \right] \left[ \begin{array} { r r } \cos \theta & - \sin \theta \\ \sin \theta & \cos \theta \end{array} \right] = \left[ \begin{array} { c c } \cos ^ { 2 } \theta - \sin ^ { 2 } \theta & - 2 \sin \theta \cos \theta \\ 2 \sin \theta \cos \theta & \cos ^ { 2 } \theta - \sin ^ { 2 } \theta \end{array} \right]
\tag{7} [ cos θ sin θ − sin θ cos θ ] [ cos θ sin θ − sin θ cos θ ] = [ cos 2 θ − sin 2 θ 2 sin θ cos θ − 2 sin θ cos θ cos 2 θ − sin 2 θ ] ( 7 ) 我们从线代得到了三角函数的恒等式!
例8. S旋转角度θ,T也是旋转-θ,那么TS=I 和 AB=I是对应的
解:在这种情况下T(S(u)) = u.为了能够匹配成功,ABx 必须等于x。所以A,B应该是互逆矩阵.下面检查一下,注意 cos ( − θ ) = cos θ , sin ( − θ ) = − sin θ \cos(-\theta) = \cos \theta,\sin(-\theta) = -\sin\theta cos ( − θ ) = cos θ , sin ( − θ ) = − sin θ
A B = [ cos θ sin θ − sin θ cos θ ] [ cos θ − sin θ sin θ cos θ ] = [ cos 2 θ + sin 2 θ 0 0 cos 2 θ + sin 2 θ ] = I A B = \left[ \begin{array} { r r } \cos \theta & \sin \theta \\ - \sin \theta & \cos \theta \end{array} \right] \left[ \begin{array} { c c } \cos \theta & - \sin \theta \\ \sin \theta & \cos \theta \end{array} \right] = \left[ \begin{array} { c c } \cos ^ { 2 } \theta + \sin ^ { 2 } \theta & 0 \\ 0 & \cos ^ { 2 } \theta + \sin ^ { 2 } \theta \end{array} \right] = I A B = [ cos θ − sin θ sin θ cos θ ] [ cos θ sin θ − sin θ cos θ ] = [ cos 2 θ + sin 2 θ 0 0 cos 2 θ + sin 2 θ ] = I 在例2,例3,我们的求导和积分的例子,T是导数变换,S是积分变换,那么变换TS是 identity,但ST不是!因为AB矩阵是单位矩阵,而BA不是单位矩阵:
A B = [ 0 1 0 0 0 0 2 0 0 0 0 3 ] [ 0 0 0 1 0 0 0 1 2 0 0 0 1 3 ] = I but B A = [ 0 0 0 0 0 1 0 0 0 0 1 0 0 0 0 1 ] A B = \left[ \begin{array} { l l l l } 0 & 1 & 0 & 0 \\ 0 & 0 & 2 & 0 \\ 0 & 0 & 0 & 3 \end{array} \right] \left[ \begin{array} { l l l } 0 & 0 & 0 \\ 1 & 0 & 0 \\ 0 & \frac { 1 } { 2 } & 0 \\ 0 & 0 & \frac { 1 } { 3 } \end{array} \right] = I \quad \text { but } \quad B A = \left[ \begin{array} { l l l l } 0 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 1 \end{array} \right] A B = 0 0 0 1 0 0 0 2 0 0 0 3 0 1 0 0 0 0 2 1 0 0 0 0 3 1 = I but B A = 0 0 0 0 0 1 0 0 0 0 1 0 0 0 0 1
The identity transformation and the Change of Basis Matrix
我们现在,求一下特别又普通的 T ( v ) = v T(v) = v T ( v ) = v 恒等变换(identity transformation) ,对v没做任何改变
如果输出基和输入基是一样的,那么T = I,对应的矩阵也没做任何事情。变换的 每一个输出 T ( v j ) = v j T(v_j) = v_j T ( v j ) = v j w j w_j w j I 。 T ( v 1 ) = v 1 = w 1 T(v_1) = v_1 = w_1 T ( v 1 ) = v 1 = w 1 v 1 v_1 v 1 w 1 w_1 w 1
但如果输入输出基基是不同的 .那么 T ( v 1 ) = v 1 T(v_1) = v_1 T ( v 1 ) = v 1 m 11 w 1 + … . + m n 1 w n m_{11} w_1+…. + m_{n1} w_n m 11 w 1 + … . + m n 1 w n
Identity transformation and change of basis matrix :(sp-mark7.2-5)
当输入和输出空间的基是不是同一组基 ,那么恒等变换 T ( v j ) = v j T(v_j) = v_j T ( v j ) = v j 组合 ∑ i = 1 n m i j w i \sum_{i=1}^n m_{ij}w_i ∑ i = 1 n m ij w i 变基矩阵(change of basis matrix).
sp:注意上面的组合二字,所以 T ( v j ) , v j T(v_j),v_j T ( v j ) , v j 基*坐标 的形式
基改变了,但是向量自身没有改变:T(v) 还是等于 v. 而且矩阵M不是 I
sp-note7.2-6:确实 T ( v j ) = v j T(v_j) = v_j T ( v j ) = v j v v v
以例9为例,设向量v在输入基的坐标是 (5,3)
输入基是 v 1 = ( 3 , 7 ) , v 2 = ( 2.5 ) v_1=(3,7),v_2=(2.5) v 1 = ( 3 , 7 ) , v 2 = ( 2.5 ) 向量形式 是 v = [ 21 50 ] v=\left[\begin{matrix} 21 \\50 \\\end{matrix} \right] v = [ 21 50 ]
根据 Eq(S7),经过T变换后,在W基下的向量形式 也是 A c = [ 3 2 7 5 ] [ 5 3 ] = [ 21 50 ] Ac = \left[ \begin{array} { l l } 3 & 2 \\ 7 & 5 \end{array} \right]\left[\begin{matrix} 5 \\3 \\\end{matrix} \right] = \left[\begin{matrix} 21 \\50 \\\end{matrix} \right] A c = [ 3 7 2 5 ] [ 5 3 ] = [ 21 50 ] w 1 = ( 1 , 0 ) , w 2 = ( 0 , 1 ) w_1=(1,0),w_2=(0,1) w 1 = ( 1 , 0 ) , w 2 = ( 0 , 1 )
v在2个基下的==坐标并不相同==!只是==v向量的形式不变==而已! 以上式子就是就是 <#Lk1 Eq(K3)>.参见Eq(S7),线性变换的矩阵A,变换了向量在不同基下的==坐标==!最终,向量的形式是什么,是要以这组基和这组基下的坐标共同确认!而对于恒等变换 T ( v j ) = v j T(v_j) = v_j T ( v j ) = v j 限制了v的形式不变,所以改变的是基,同时坐标也改变了! (参见<sp-note-N1>)
例9. 输入基 v 1 = ( 3 , 7 ) , v 2 = ( 2.5 ) v_1=(3,7),v_2=(2.5) v 1 = ( 3 , 7 ) , v 2 = ( 2.5 ) w 1 = ( 1 , 0 ) , w 2 = ( 0 , 1 ) w_1=(1,0),w_2=(0,1) w 1 = ( 1 , 0 ) , w 2 = ( 0 , 1 )
T ( v ) = v 对应的矩阵是 M = [ 3 2 7 5 ] Change of basis T ( v ) = v \text{ 对应的矩阵是} \quad \quad M = \left[ \begin{array} { l l } 3 & 2 \\ 7 & 5 \end{array} \right]
\quad \color{orange} \text{Change of basis} T ( v ) = v 对应的矩阵是 M = [ 3 7 2 5 ] Change of basis 因为:第一个输入基 v v v 3 w 1 + 7 w 2 3w_1+7w_2 3 w 1 + 7 w 2
这看起来好像太简单了,没什么重要的.但是当基变换以另一种方式出现的时候,会变的棘手.下面的例子,我们得到的是这个M的逆矩阵
例10. 输入基现在是 v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) v_1=(1,0),v_2=(0,1) v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) T ( v ) = v T(v) = v T ( v ) = v w 1 = ( 3 , 7 ) , w 2 = ( 2 , 5 ) w_1=(3,7),w_2=(2,5) w 1 = ( 3 , 7 ) , w 2 = ( 2 , 5 )
T ( v ) = v 对应的矩阵是 [ 3 2 7 5 ] − 1 = [ 5 − 2 − 7 3 ] reverse the bases invert the matrix T ( v ) = v \quad \text { 对应的矩阵是 } \left[ \begin{array} { l l } 3 & 2 \\ 7 & 5 \end{array} \right] ^ { - 1 } = \left[ \begin{array} { r r } 5 & - 2 \\ - 7 & 3 \end{array} \right]
\quad
\begin{aligned}
\color{orange} \text{reverse the bases}\\
\color{orange} \text{invert the matrix}
\end{aligned} T ( v ) = v 对应的矩阵是 [ 3 7 2 5 ] − 1 = [ 5 − 7 − 2 3 ] reverse the bases invert the matrix 因为:第一个输入基是 v 1 = ( 1 , 0 ) v_1=(1,0) v 1 = ( 1 , 0 ) v 1 v_1 v 1 5 w 1 − 7 w 2 5w_1 −7w_2 5 w 1 − 7 w 2 5(3,7)- 7(2,5)= (1,0).我们这里做的是,把例9M的列组合起来产生 I 的列.能做这件是的矩阵就是 M − 1 M^{−1} M − 1
[ w 1 w 2 ] [ 5 − 2 − 7 3 ] = [ v 1 v 2 ] 其实是 M M − 1 = I Change basis Change back (M1) \left[ \begin{array} { l l } w _ { 1 } & w _ { 2 } \end{array} \right] \left[ \begin{array} { r r } 5 & - 2 \\ - 7 & 3 \end{array} \right] = \left[ \begin{array} { l l } v _ { 1 } & v _ { 2 } \end{array} \right] \text { 其实是 } M M ^ { - 1 } = I
\quad
\begin{aligned}
\color{orange} \text{Change basis}\\
\color{orange} \text{Change back}
\end{aligned}
\tag{M1} [ w 1 w 2 ] [ 5 − 7 − 2 3 ] = [ v 1 v 2 ] 其实是 M M − 1 = I Change basis Change back ( M1 ) 通过这2个例题,我们从基 (1,0),(0,1)开始,也从 基 (1,0),(0,1) 结束.矩阵乘法必须得到 I.所以这2个基变换矩阵必须是逆矩阵
sp:例9,例10想表达的是:在恒等变换 T(v) = v当中,矩阵M从基A变到基B,那么矩阵 M − 1 M^{-1} M − 1 <#Lk1> 的Eq(k3,k4)
Wavelet Transform=Change to wavelet Basis
小波基有不同的长度而且分布位置也是不同的,下面的第一个基向量其实不是一个小波,它是一个很有用的分量都是1的向量.下面的是Haar Wavelet:
Haar basis: w 1 = [ 1 1 1 1 ] w 2 = [ 1 1 − 1 − 1 ] w 3 = [ 1 − 1 0 0 ] w 4 = [ 0 0 1 − 1 ] (8) \text{Haar basis: }\quad w _ { 1 } = \left[ \begin{array} { l } 1 \\ 1 \\ 1 \\ 1 \end{array} \right] \quad w _ { 2 } = \left[ \begin{array} { r } 1 \\ 1 \\ - 1 \\ - 1 \end{array} \right] \quad w _ { 3 } = \left[ \begin{array} { r } 1 \\ - 1 \\ 0 \\ 0 \end{array} \right] \quad w _ { 4 } = \left[ \begin{array} { r } 0 \\ 0 \\ 1 \\ - 1 \end{array} \right]
\tag{8} Haar basis: w 1 = 1 1 1 1 w 2 = 1 1 − 1 − 1 w 3 = 1 − 1 0 0 w 4 = 0 0 1 − 1 ( 8 ) 这些向量是正交 的,非常好.注意看 w 3 w_3 w 3 w 4 w_4 w 4 v = ( v 1 , v 2 , v 3 , v 4 ) v = (v_1,v_2,v_3,v_4) v = ( v 1 , v 2 , v 3 , v 4 ) c 1 , c 2 , c 3 , c 4 c_1 ,c_2,c_3,c_4 c 1 , c 2 , c 3 , c 4
Transform v to c: v = c 1 w 1 + c 2 w 2 + c 3 w 3 + c 4 w 4 = W c (9) \text {Transform v to c:} \quad v = c _ { 1 } w _ { 1 } + c _ { 2 } w _ { 2 } + c _ { 3 } w _ { 3 } + c _ { 4 } w _ { 4 } = W c
\tag{9} Transform v to c: v = c 1 w 1 + c 2 w 2 + c 3 w 3 + c 4 w 4 = W c ( 9 ) 系数 c 3 c_3 c 3 c 4 c_4 c 4 c 1 c_1 c 1
为什么我们要变基?设 v 1 , v 2 , v 3 , v 4 v_1,v_2,v_3,v_4 v 1 , v 2 , v 3 , v 4
但如果我们保持的是5%标准基的系数,我们就丢失了95%的信号.但是如果我们选择了更好的基 w's,这些基组合起来可以很接近原始的信号,你甚至发现不了有什么差别,原理上来说,我们不需要其他的95%!
第1个基向量是 ( 1 , 1 , 1 , 1 ) (1,1,1,1) ( 1 , 1 , 1 , 1 ) (0,0,1,-1) 的短波(当然可以更高维度,如 (0,0,0,0,0,0,1,-1))可以代表信号末尾的细节
变换有3个步骤:变换,压缩,逆变换(inverse transform)
> > input v → ⏟ l o s s l e s s coefficients c > → ⏟ l o s s y compressed c ^ > → ⏟ r e s c o n s t r u c t compressed v ^ > > \large
> \text{input v} \underbrace{\rightarrow}_{lossless} \text{ coefficients c}
> \underbrace{\rightarrow}_{lossy} \text{compressed } \widehat{c} \
> \underbrace{\rightarrow}_{resconstruct} \text{compressed } \widehat{v}
> > > input v l oss l ess → coefficients c > l ossy → compressed c > r esco n s t r u c t → compressed v >
在线代,因为任何事情都是完美的,所以我们省略压缩环节,也就是说,输出 v ^ \widehat{v} v v 是一样的.变换给出 c = w − 1 v c = w^{−1} v c = w − 1 v v = W c v = Wc v = W c v ^ = W c ^ \widehat{v} = W\widehat{c} v = W c
我会对一个典型向量 v = (6,4,5,1) 展示一下这些步骤,它的小波系数是 c = ( 4 , 1 , 1 , 2 ) . v = W c c = (4,1,1,2).v = Wc c = ( 4 , 1 , 1 , 2 ) . v = W c 4 w 1 + w 2 + w 3 + 2 w 4 4w_1 + w_2+ w_3+2w_4 4 w 1 + w 2 + w 3 + 2 w 4
[ 6 4 5 1 ] = 4 [ 1 1 1 1 ] + [ 1 1 − 1 − 1 ] + [ 1 − 1 0 0 ] + 2 [ 0 0 1 − 1 ] = [ 1 1 1 0 1 1 − 1 0 1 − 1 0 1 1 − 1 0 − 1 ] [ 4 1 1 2 ] (10) \left[ \begin{array} { l } 6 \\ 4 \\ 5 \\ 1 \end{array} \right] = 4 \left[ \begin{array} { l } 1 \\ 1 \\ 1 \\ 1 \end{array} \right] + \left[ \begin{array} { r } 1 \\ 1 \\ - 1 \\ - 1 \end{array} \right] + \left[ \begin{array} { r } 1 \\ - 1 \\ 0 \\ 0 \end{array} \right] + 2 \left[ \begin{array} { r } 0 \\ 0 \\ 1 \\ - 1 \end{array} \right] = \left[ \begin{array} { r r r r } 1 & 1 & 1 & 0 \\ 1 & 1 & - 1 & 0 \\ 1 & - 1 & 0 & 1 \\ 1 & - 1 & 0 & - 1 \end{array} \right] \left[ \begin{array} { l } 4 \\ 1 \\ 1 \\ 2 \end{array} \right]
\tag{10} 6 4 5 1 = 4 1 1 1 1 + 1 1 − 1 − 1 + 1 − 1 0 0 + 2 0 0 1 − 1 = 1 1 1 1 1 1 − 1 − 1 1 − 1 0 0 0 0 1 − 1 4 1 1 2 ( 10 ) 系数c是 W − 1 v W^{−1} v W − 1 v W − 1 = W T W^{−1}= W^T W − 1 = W T
W − 1 = [ 1 4 1 4 1 2 1 2 ] [ 1 1 1 1 1 1 − 1 − 1 1 − 1 0 0 0 0 1 − 1 ] W ^ { - 1 } = \left[ \begin{array} { r r r r r } \frac { 1 } { 4 } & & & \\ & \frac { 1 } { 4 } & & \\ & & \frac { 1 } { 2 } & \\ & & & \frac { 1 } { 2 } \end{array} \right] \left[ \begin{array} { r r r r } 1 & 1 & 1 & 1 \\ 1 & 1 & - 1 & - 1 \\ 1 & - 1 & 0 & 0 \\ 0 & 0 & 1 & - 1 \end{array} \right] W − 1 = 4 1 4 1 2 1 2 1 1 1 1 0 1 1 − 1 0 1 − 1 0 1 1 − 1 0 − 1 c = W − 1 v c= W^{−1} v c = W − 1 v c 1 = 4 c_1=4 c 1 = 4
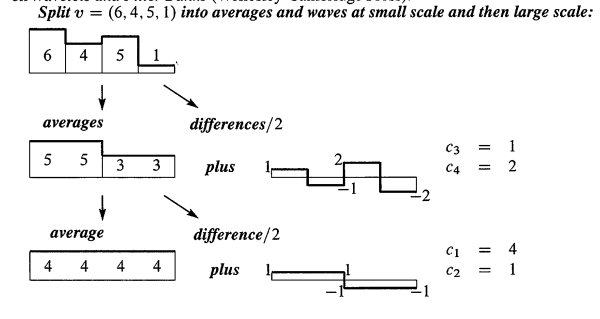
例11. Same Wavelet Basis By recursion . 我忍不住想要展示一个快速找到c的方法.小波基的特点是你可以在选择出 c 2 c_2 c 2 c 1 c_1 c 1 c 3 , c 4 c_3,c_4 c 3 , c 4 <Wavelets and Filter Banks>第一章)
sp:不懂这幅图是什么意思....
Fourier Transform(DFT) = change to Fourier Basis
一个电机工程师(electrical enigneer)对信号做的第一件事就是进行傅里叶变换.对于有限的向量,我们说的其实是离散傅里叶变换(Discrete Fourier transform),DFT涉及到复数 (e 2 π i / n e^{2πi/n} e 2 π i / n i i i i 3 = − i i^3=−i i 3 = − i
F = [ 1 1 1 1 1 i i 2 i 3 1 i 2 i 4 i 6 1 i 3 i 6 i 9 ] Fourier basis w 1 to w 4 in the columns of F F = \left[ \begin{array} { c c c c } 1 & 1 & 1 & 1 \\ 1 & i & i ^ { 2 } & i ^ { 3 } \\ 1 & i ^ { 2 } & i ^ { 4 } & i ^ { 6 } \\ 1 & i ^ { 3 } & i ^ { 6 } & i ^ { 9 } \end{array} \right]
\quad \color{orange} \text{Fourier basis } w_1 \text{ to }w_4 \text{in the columns of F} F = 1 1 1 1 1 i i 2 i 3 1 i 2 i 4 i 6 1 i 3 i 6 i 9 Fourier basis w 1 to w 4 in the columns of F 第一列仍然是那个有用的向量 (1,1,1,1).它代表是的平均信号或者当前电流,其频率是0.第3列是 (1,-1,1,-1),以最高频率交替。傅里叶变换把信号分解为频率均匀分布的波(The Fourier transform decomposes the signal into waves at equally spaced frequencies)
傅里叶矩阵F绝对是数学,科学和工程上最重要的复数矩阵.<01-10 #3> 会讨论快速傅里叶变换(FFT):可以看成是把F分解成很多个元素是很多0的矩阵组.FFT变革了整个工业!美丽的事实是,F − 1 F^{−1} F − 1 i 变成 -i
Matlab命令 c = fft(v) 产生的是向量v的傅里叶系数 c 1 . . . c n c_1...c_n c 1 ... c n F − 1 F^{−1} F − 1
这里是V32的一部分,其他部分总结到合适的地方,请搜索V32即可
信号压缩,图像压缩,本质上就是基变换.本章的主题是线性变换和矩阵的关联,线性变换不需要在坐标系内,而矩阵则把线性变换用坐标的方式表示,矩阵是基于坐标描述线性变换的.
首先说图像压缩的基础知识,如课程的录像就是压缩过的,你会看到黑板上的东西很清晰,但如果我来回走动,会需要相当多的字节,我就会被压缩的很厉害.
有些压缩是无损的,只压掉多余的,而我们要讲的是有损压缩。如果是一个512*512像素构成的黑白静态图片,那么像素就是灰度值(gray-scale),从0到255,2 8 2^8 2 8 x i x_i x i 512 2 512^2 51 2 2 R n R^n R n 512 2 512^2 51 2 2 3 ∗ 512 2 3*512^2 3 ∗ 51 2 2
标准压缩法叫做JPEG,表示联合图像专家组(Joint Photographic Experts Group),原理就是基变换!以上述图片为例,我们有什么样的基呢?可以认为是,每一个像素的每一个值都是标准基的一个分量,那么我们有分量长度为 512 2 512^2 51 2 2
标准基是如下:
[ 1 ⋮ 0 0 ] [ 0 1 ⋮ 0 ] ⋯ [ 0 0 ⋮ 1 ] \left[\begin{matrix}1\\ \vdots \\0 \\0 \end{matrix} \right] \quad
\left[\begin{matrix}0\\ 1 \\\vdots \\0 \end{matrix} \right] \quad \cdots
\left[\begin{matrix}0\\ 0 \\\vdots \\1 \end{matrix} \right] \quad 1 ⋮ 0 0 0 1 ⋮ 0 ⋯ 0 0 ⋮ 1 空白黑板就是一副标准基很差的图像, 因为大部分的像素点的灰度值,和相邻的差不多.而标准基根本没有利用这一点。那么怎么利用这一点呢?一个非常好的基向量就是所有元素都为1的向量:
[ 1 ⋮ 1 1 ] [ 1 ⋮ 1 − 1 ⋮ − 1 ] ⋯ [ 1 − 1 1 − 1 ⋮ 1 − 1 ] \left[\begin{matrix}1\\ \vdots \\1 \\1 \end{matrix} \right] \quad
\left[\begin{matrix} 1 \\\vdots \\ 1 \\-1 \\ \vdots\\-1 \end{matrix} \right] \quad \cdots
\left[\begin{matrix}1\\ -1 \\1 \\ -1 \\\vdots \\1 \\ -1 \end{matrix} \right] \quad 1 ⋮ 1 1 1 ⋮ 1 − 1 ⋮ − 1 ⋯ 1 − 1 1 − 1 ⋮ 1 − 1 注意
分量全是1的基向量:这个单一的向量,就能完整的给出这个所有像素基本相同的图像的信息.
最后一个向量是一个棋盘向量,1、-1交替出现。如果图像是一个很大的棋盘,一格白一格黑,那么第3个向量就能表示这个棋盘所有信息了
更常见的是一半图像暗,另一半亮,这时候第2个向量就是很有用的向量,一半是1一半是-1
如果选择基?归根结底是线性代数的问题,基的选择问题.
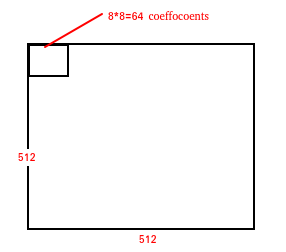
提一下JPEG使用的最好的基:傅里叶基!注意,对于512-512的图片,JPEG会做的就是,把图片分解成8-8的小块,每个8-8的小块有64个系数(也就是64个像素),然后在这个8-8的小块上做基变换,因为一次处理512*512太大了.如下图
如下是 8-8 的傅里叶基
( 参见视频 24 或 27 ) , 这里教授没写出来 (F1) (参见视频24或27),这里教授没写出来
\tag{F1} ( 参见视频 24 或 27 ) , 这里教授没写出来 ( F1 ) 每一个小块内,有64个系数,64个基向量,64个像素,所以我们是在64维空间中,利用傅里叶向量做基变换,注意,这是无损压缩步骤.
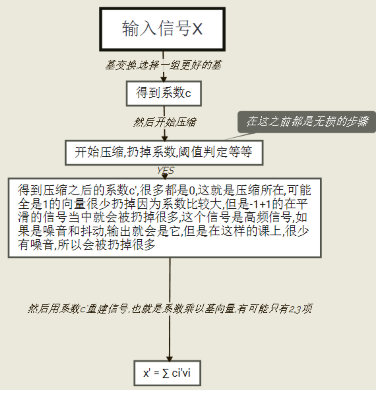
压缩步骤:
输入向量x,然后进行基变换,选择一组更好的基,得到系数c.所以输入64个像素,得到64个系数,然后是压缩,这是无损压缩.
我们知道R 64 R^{64} R 64
经过压缩步骤之后,我们就得到了系数 c',它的分量很多是0。可能 Eq(F1) 全是1的基向量很少扔掉,因为它的系数比较大。但类似 1,-1 交替出现的基向量就会被扔掉很多,因为它是高频信号(1,-1...变化很大,而类似与 1...1 的全1向量就是频率为0).
然后系数 c' 重建信号: x ′ = ∑ c i ′ v i x' = \sum c_i'v_i x ′ = ∑ c i ′ v i
对于视频,可认为是一幅幅静态图像,压缩,然后播放成视频.这不是理想的方法,因为视频是一系列连续图像,一副图像和下一副相当接近,所以得用预估和修正(prediction and correction),你要假设图像都是上一副图,加一点小的修正,得到下一副图.压缩总是用到关联性[correlated],实际上,在时间空间上,物体不会变幻剧烈,而是平滑的变换,所以可以根据前一个值预测下一个值.
再讲一点傅里叶基的竞争对手:小波(wavelets).以8-8为例.如下就是小波基 w 1 . . . w 8 w_1...w_8 w 1 ... w 8
[ 1 1 1 1 1 1 1 1 ] [ 1 1 1 1 − 1 − 1 − 1 − 1 ] [ 1 1 − 1 − 1 0 0 0 0 ] [ 0 0 0 0 1 1 − 1 − 1 ] [ 1 − 1 0 0 0 0 0 0 ] . . . (F0) \left[\begin{matrix}1\\1\\1\\ 1 \\ 1\\1\\1\\1 \end{matrix} \right]
\left[\begin{matrix}1\\1\\1\\ 1 \\ -1\\-1\\-1\\-1 \end{matrix} \right]
\left[\begin{matrix}1\\1\\-1\\ -1 \\ 0\\0\\0\\0 \end{matrix} \right]
\left[\begin{matrix}0\\0\\0\\ 0 \\ 1\\1\\-1\\-1 \end{matrix} \right]
\qquad
\left[\begin{matrix}1\\-1\\0\\ 0 \\ 0\\0\\0\\0 \end{matrix} \right]
... \tag{F0} 1 1 1 1 1 1 1 1 1 1 1 1 − 1 − 1 − 1 − 1 1 1 − 1 − 1 0 0 0 0 0 0 0 0 1 1 − 1 − 1 1 − 1 0 0 0 0 0 0 ... ( F0 )
先是8个1
然后4个1,4个-1,
然后是2个1,2个-1,4个0,
然后4个0,2个1,2个-1
然后1,-1,6个0
后面略
这就是8维空间下的小波基(这个比较简单,还有更精密的小波基).
现在问,对于 [1,-1...1,-1] 这样的向量,这么用小波基去表示?其实就是上述小波基后面4个之和。而线代就是要,给定基(如小波基),找出系数 c'(上面压缩步骤第3步)。
现在假设使用小波基,然后给定像素值 P 1 ∼ P 8 P_1 \sim P_8 P 1 ∼ P 8 P i P_i P i 系数 ,那么要确定的就是使用小波基表示成组合形式
P = c 1 w 1 + . . . + c 8 w 8 (F2) P = c_1w_1+...+c_8w_8 \tag{F2} P = c 1 w 1 + ... + c 8 w 8 ( F2 ) 上式就是这是无损变换.要确定的就是那些系数c i c_i c i c i c_i c i w 1 . . . w 8 w_1...w_8 w 1 ... w 8 Eq(F2)的 c i c_i c i
P = [ 1 1 ⋯ 1 1 ⋯ 1 1 ⋯ 1 1 ⋯ 1 − 1 ⋯ 1 − 1 ⋯ 1 − 1 ⋯ 1 − 1 ⋯ ] ⏟ Eq(F0),8-8 wavlets basis Matrix W ∗ [ c 1 c 2 ⋮ c 8 ] (F3) P =
\underbrace{ \left[\begin{matrix}
1 & 1 &\cdots\\
1 & 1 & \cdots \\
1 & 1 &\cdots \\
1 & 1 &\cdots \\
1 & -1 &\cdots \\
1 & -1 &\cdots \\
1 & -1 &\cdots \\
1 & -1 &\cdots \\
\end{matrix} \right]
}_{ \text{Eq(F0),8-8 wavlets basis Matrix W}} *
\left[\begin{matrix}c_1\\c_2\\\vdots\\c_8 \end{matrix} \right]
\tag{F3} P = Eq(F0),8-8 wavlets basis Matrix W 1 1 1 1 1 1 1 1 1 1 1 1 − 1 − 1 − 1 − 1 ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ ∗ c 1 c 2 ⋮ c 8 ( F3 ) 小波基组成的矩阵W。终于到了基变换的步骤。求解 P = W c P = Wc P = W c c = W − 1 P c = W^{−1} P c = W − 1 P
1 计算快 。也就是乘以基向量组成的矩阵W , W − 1 W,W^{-1} W , W − 1
傅里叶基可以快速傅里叶变换(FFT)
小波基快速小波变换(FWT)
而且小波矩阵很容易求逆,因为
Eq(F0)的基向量,都是由 1,-1,0 构成,所以乘法非常快.
它们是正交的!基向量正交!虽然目前不是标准正交的,但化为标准正交也很简单。正交之后,W − 1 W^{−1} W − 1 <01-04>,如果列向量标准正交,那么逆就是转置!超级快!
2 性质好 。如果我们不改变基,保持标准基不变,是一点都不菲时间,但是从压缩的角度来看就不好了,因为不能扔掉系数,不能压缩.相反,如果基性质很好,扔掉一些基,比如 w 5 − w 8 w_5-w_8 w 5 − w 8 c 5 − w 8 c5 - w_8 c 5 − w 8
复习一下上节课,假设基 v 1 ∼ v 8 v_1 \sim v_8 v 1 ∼ v 8 v 1 ∼ v 8 v_1 \sim v_8 v 1 ∼ v 8 T ( v 1 ) ∼ T ( v 8 ) T(v_1) \sim T(v_8) T ( v 1 ) ∼ T ( v 8 ) v 1 ∼ v 8 v_1 \sim v_8 v 1 ∼ v 8
sp:本段参见V32 40分开始。一直以为讲授讲错了,把新的基和旧的基混合成同一组,但不是啊,这里的意思就是输入、输出基相同的情况下,T变换对应的矩阵
x = c 1 v 1 + . . . + c 8 v 8 x = c_1v_1 +... + c_8v_8 x = c 1 v 1 + ... + c 8 v 8 从而 x 的变换T(x)就是 T ( v 1 ) ∼ T ( v 8 ) T(v_1) \sim T(v_8) T ( v 1 ) ∼ T ( v 8 )
T ( x ) = c 1 T ( v 1 ) + . . . + c 8 T ( v 8 ) T(x) = c_1T(v_1) +... + c_8T(v_8) T ( x ) = c 1 T ( v 1 ) + ... + c 8 T ( v 8 ) 现在问题是,要把变换 T ( v 1 ) ∼ T ( v 8 ) T(v_1) \sim T(v_8) T ( v 1 ) ∼ T ( v 8 ) v 1 ∼ v 8 v_1 \sim v_8 v 1 ∼ v 8
T ( v 1 ) = a 11 v 1 + a 21 v 2 + . . . + a 81 v 8 T ( v 2 ) = a 12 v 1 + a 22 v 2 + . . . + a 82 v 8 ⋮ T ( v 8 ) = a 18 v 1 + a 28 v 2 + . . . + a 88 v 8 T(v_1) = a_{11}v_1+a_{21}v_2+...+a_{81}v_8\\
T(v_2) = a_{12}v_1+a_{22}v_2+...+a_{82}v_8 \\
\vdots\\
T(v_8) = a_{18}v_1+a_{28}v_2+...+a_{88}v_8 T ( v 1 ) = a 11 v 1 + a 21 v 2 + ... + a 81 v 8 T ( v 2 ) = a 12 v 1 + a 22 v 2 + ... + a 82 v 8 ⋮ T ( v 8 ) = a 18 v 1 + a 28 v 2 + ... + a 88 v 8 得到矩阵A
A = [ a 11 ⋯ a 81 ⋮ ⋯ ⋮ a 81 ⋯ a 88 ] A = \left[\begin{matrix}
a_{11} & \cdots & a_{81}\\
\vdots & \cdots & \vdots\\
a_{81} & \cdots & a_{88}\\
\end{matrix} \right] A = a 11 ⋮ a 81 ⋯ ⋯ ⋯ a 81 ⋮ a 88 也就是说,给定条件
然后需要你计算,每个基向量的变换 T ( v i ) T(v_i) T ( v i )
现在假设 v 1 ∼ v 8 v_1 \sim v_8 v 1 ∼ v 8 T ( v i ) T(v_i) T ( v i ) v i v_i v i T ( v i ) = λ i v i T(v_i) = \lambda_i v_i T ( v i ) = λ i v i
首先我们确认一下A的第一列:取第1个基向量 v 1 v_1 v 1 T ( v 1 ) = λ 1 v 1 T(v_1) = \lambda_1 v_1 T ( v 1 ) = λ 1 v 1 T ( v 1 ) = λ 1 v 1 T(v_1) = \lambda_1 v_1 T ( v 1 ) = λ 1 v 1 λ 1 v 1 \lambda_1 v_1 λ 1 v 1 λ 1 \lambda_1 λ 1
[ λ 1 0 ⋮ 0 ] \left[\begin{matrix}\lambda_1\\0\\\vdots\\0\\ \end{matrix} \right] λ 1 0 ⋮ 0 其他基向量同样如此处理,最终得到
A = [ λ 1 0 0 0 λ 2 0 0 0 ⋯ ⋮ ⋮ ⋮ λ n ] A = \left[\begin{matrix}
\lambda_1 & 0 & &0\\
0 & \lambda_2 & & 0\\
0 & 0 & \cdots & \vdots\\
\vdots & \vdots & & \lambda_n\\
\end{matrix} \right] A = λ 1 0 0 ⋮ 0 λ 2 0 ⋮ ⋯ 0 0 ⋮ λ n 在特征向量基下,矩阵是对角阵!使我们在图像处理当中的完美矩阵,但是求特征向量的代价太大了
sp:这里可以参见<#Lk1.4> 的特征向量为基的例子
如果对于一组基 v 1 . . . v n v_1...v_n v 1 ... v n T ( v 1 ) . . . T ( v n ) T(v_1)...T(v_n) T ( v 1 ) ... T ( v n ) T ( v ) T(v) T ( v )
输入基是 v 1 . . . v n v_1...v_n v 1 ... v n w 1 . . . w m w_1...w_m w 1 ... w m
如果A,B代表了变换T和S,而且S的输出基是T的输入基,那么矩阵AB代表了变换 T(S(u))
(来自V31):矩阵的逆相当于线性变换的逆!矩阵的乘积相当于线性变换的乘积,实际上矩阵乘法也来源于线性变换!
1. 使用标准基,求一个表示循环排列变换(cyclic permutation) T 的4-4的矩阵P,也就是把 x = ( x 1 , x 2 , x 3 , x 4 ) x = (x_1,x_2,x_3,x_4) x = ( x 1 , x 2 , x 3 , x 4 ) T ( x ) = ( x 4 , x 1 , x 2 , x 3 ) T(x) = (x_4,x_1,x_2,x_3) T ( x ) = ( x 4 , x 1 , x 2 , x 3 ) T 2 T^2 T 2 T 3 ( x ) T^3(x) T 3 ( x ) T 3 = T − 1 T^3 = T^{-1} T 3 = T − 1
解: 在标准基下,设 x = ( 1 , 0 , 0 , 0 ) x= (1,0,0,0) x = ( 1 , 0 , 0 , 0 ) T ( x ) = ( 0 , 1 , 0 , 0 ) T(x) =(0,1,0,0) T ( x ) = ( 0 , 1 , 0 , 0 ) ( 0 , 1 , 0 , 0 ) (0,1,0,0) ( 0 , 1 , 0 , 0 )
P = [ 0 0 0 1 1 0 0 0 0 1 0 0 0 0 1 0 ] → P [ x 1 x 2 x 3 x 4 ] = [ x 4 x 1 x 2 x 3 ] P = \left[ \begin{array} { l l l l } 0 & 0 & 0 & 1 \\ 1 & 0 & 0 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \end{array} \right] \quad \rightarrow P \left[ \begin{array} { l } x _ { 1 } \\ x _ { 2 } \\ x _ { 3 } \\ x _ { 4 } \end{array} \right] = \left[ \begin{array} { l } x _ { 4 } \\ x _ { 1 } \\ x _ { 2 } \\ x _ { 3 } \end{array} \right] P = 0 1 0 0 0 0 1 0 0 0 0 1 1 0 0 0 → P x 1 x 2 x 3 x 4 = x 4 x 1 x 2 x 3 因为使用的是标准基,所以T变换就是乘以P矩阵(sp:这里的意思是输入基和输出基是同1个,所以T 2 , T 3 T^2,T^3 T 2 , T 3
T 2 T^2 T 2 P 2 P^2 P 2 x = ( x 1 , x 2 , x 3 , x 4 ) x = (x_1,x_2,x_3,x_4) x = ( x 1 , x 2 , x 3 , x 4 ) x = ( x 3 , x 4 , x 1 , x 2 ) x = (x_3,x_4,x_1,x_2) x = ( x 3 , x 4 , x 1 , x 2 ) T 3 T^3 T 3 P 3 P^3 P 3 x = ( x 1 , x 2 , x 3 , x 4 ) x = (x_1,x_2,x_3,x_4) x = ( x 1 , x 2 , x 3 , x 4 ) T 3 ( x ) = ( x 2 , x 3 , x 4 , x 1 ) T^3(x) = (x_2,x_3,x_4,x_1) T 3 ( x ) = ( x 2 , x 3 , x 4 , x 1 )
如果对 T 3 T^3 T 3 T 4 T^4 T 4 P 4 = I P^4 = I P 4 = I P 3 P = I , P 3 = P − 1 P^3 P = I,P^3 = P^{-1} P 3 P = I , P 3 = P − 1
P的实数特征向量是:λ 1 = 1 , x 1 = ( 1 , 1 , 1 , 1 ) ; λ 2 = − 1 , x 2 = ( 1 , − 1 , 1 , − 1 ) \lambda_1 = 1,x_1 = (1,1,1,1);\lambda_2 =-1,x_2 = (1,-1,1,-1) λ 1 = 1 , x 1 = ( 1 , 1 , 1 , 1 ) ; λ 2 = − 1 , x 2 = ( 1 , − 1 , 1 , − 1 ) x 1 x_1 x 1 x 2 x_2 x 2 i , − i i,-i i , − i λ 1 λ 2 λ 3 λ 4 = − 1 \lambda_1\lambda_2\lambda_3\lambda_4 = -1 λ 1 λ 2 λ 3 λ 4 = − 1
注意 1 , − 1 , i , − i 1,-1,i,-i 1 , − 1 , i , − i det ( P − λ I ) = λ 4 − 1 \det(P - \lambda I)= \lambda^4 - 1 det ( P − λ I ) = λ 4 − 1 0 , 90 , 180 , 270 0,90,180,270 0 , 90 , 180 , 270 傅里叶矩阵F就是P的特征向量矩阵!
2. 2-2的矩阵有4个 "向量" 作为基:
v 1 = [ 1 0 0 0 ] v 2 = [ 0 1 0 0 ] v 3 = [ 0 0 1 0 ] v 4 = [ 0 0 0 1 ] \boldsymbol { v } _ { 1 } = \left[ \begin{array} { l l } 1 & 0 \\ 0 & 0 \end{array} \right] \quad \boldsymbol { v } _ { 2 } = \left[ \begin{array} { l l } 0 & 1 \\ 0 & 0 \end{array} \right] \quad \boldsymbol { v } _ { 3 } = \left[ \begin{array} { l l } 0 & 0 \\ 1 & 0 \end{array} \right] \quad \boldsymbol { v } _ { 4 } = \left[ \begin{array} { l l } 0 & 0 \\ 0 & 1 \end{array} \right] v 1 = [ 1 0 0 0 ] v 2 = [ 0 0 1 0 ] v 3 = [ 0 1 0 0 ] v 4 = [ 0 0 0 1 ] 设T是转置任何2-2矩阵的线性变换,那么在上面的基作为输入基和输出基的时候,什么矩阵A能表示这样的变换?A − 1 A^{-1} A − 1 T − 1 T^{-1} T − 1
解:我们变换4个基得到A的4列,发现矩阵A直接调换了 v 2 , v 3 v_2,v_3 v 2 , v 3
T ( v 1 ) = v 1 T ( v 2 ) = v 3 T ( v 3 ) = v 2 T ( v 4 ) = v 4 ⇒ A = [ 1 0 0 0 0 0 1 0 0 1 0 0 0 0 0 1 ] \begin{array} { l } T \left( v _ { 1 } \right) = v _ { 1 } \\ T \left( v _ { 2 } \right) = v _ { 3 } \\ T \left( v _ { 3 } \right) = v _ { 2 } \\ T \left( v _ { 4 } \right) = v _ { 4 } \end{array}
\quad \Rightarrow \quad
A = \left[ \begin{array} { l l l l } 1 & 0 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 1 & 0 & 0 \\ 0 & 0 & 0 & 1 \end{array} \right] T ( v 1 ) = v 1 T ( v 2 ) = v 3 T ( v 3 ) = v 2 T ( v 4 ) = v 4 ⇒ A = 1 0 0 0 0 0 1 0 0 1 0 0 0 0 0 1 A − 1 A^{-1} A − 1 T − 1 T^{-1} T − 1
Diagonalization and the Pseudoinverse
通过选择更好的基,可以产生更好的线性变换矩阵!如果想要矩阵是对角矩阵:
第1个方法是把特征向量作为基
第2个方法是2组不同的基:输入基和输出基不同,也就是SVD当中学习的:左右奇异向量是A的四个基础子空间的单位正交 基向量。通过逆转这些输入输出基,我们可以得到A的伪逆 。矩阵 A + A^+ A + R m R^m R m R n R^n R n A + A^+ A + R m R^m R m R n R^n R n
事实上,对A所有的伟大的分解,都可以看成是变基 .但这一节篇幅太小,我们把注意力集中到2个突出的例子:变换T对应的矩阵A都是对角矩阵:
1组基情况(<#3.1>): 以矩阵A的特征向量同时作为输入、输出基,这时 S − 1 A S = Λ S^{-1}AS = \Lambda S − 1 A S = Λ Λ \Lambda Λ m=n,矩阵A必须是方阵(但注意有些方阵的没有n个独立的特征向量,不能对角化)。
sp:矩阵A的特征向量,什么矩阵A?应该理解为标准基下T变换对应的矩阵A!以下是V31视频下网友的总结
<V31总结>:教授讲解时,提到了以特征向量为基时,线性变换的矩阵是对角阵的结论。
首先,谁的特征向量?不妨说就是线性变换标准基下对应矩阵的特征向量 。
其次,特征向量和特征值的几何意义是什么?不妨设标准基下的线性变换对应矩阵A,T ( v ) = A v T(v)=Av T ( v ) = A v 线性变换的变换方向 ,即向量v旋转伸缩的方向,特征值就是伸缩的幅度 。那么如果以矩阵A的变换方向(特征向量)作为基构造坐标系,线性变换的旋转伸缩方向指向了自身,改变的只有幅度 ,所以这组基对应的线性变换的作用就是只改变幅度不改变方向,能起到这种作用的线性变换矩阵就是以特征值为对角的对角阵 。
2组基情况 (<#3.2>):基分别是 A T A A^TA A T A A A T AA^T A A T U − 1 A V = Σ U^{-1}AV = \Sigma U − 1 A V = Σ Σ \Sigma Σ
此时输入输出基是不一样的.矩阵A可以是矩形的.基是单位正交 的,因为 A T A , A A T A^T A,AA^T A T A , A A T U − 1 = U T , V − 1 = V T U^{−1}= U^T,V^{−1}= V^T U − 1 = U T , V − 1 = V T Σ Σ Σ <01-06> 的SVD知识!
只有当 A T A = A A T A^TA = AA^T A T A = A A T Σ \Sigma Σ σ i = ∣ λ i ∣ \sigma_i = |\lambda_i| σ i = ∣ λ i ∣ Σ = a b s ( Λ ) \Sigma = abs(\Lambda) Σ = ab s ( Λ ) A T A = A A T A^TA = AA^T A T A = A A T e i θ e^{i\theta} e i θ
提醒一下,GS分解 A=QR 只能给出1组新的基:也就是由Q得到的正交输出基。 而输入基是 I 指定的标准基。我们没有得到对角的 Σ \Sigma Σ A = Q R I A= QRI A = QR I
首先从输入输出基相等的时候开始,这会产生 S , S − 1 S,S^{-1} S , S − 1
从方阵和1组基:I 的列,也就是标准基开始,输入空间 V 是 R n R^n R n R n R^n R n
<01-02>,我们通过消去化简矩阵是上下三角<01-04>,<01-06>,我们通过GS正交化和特征向量,把矩阵化为对角(diagonal)
现在我们把A化为 Λ \Lambda Λ 来自特征向量基的特征值矩阵(Eigenvalue matrix from eigenvector basis)
提前说一下
当你改变了V的基,矩阵A变为AM。因为V是输入空间,所以矩阵M是在右边的(首先起作用)
当你改变了W的基,矩阵A变为M − 1 A M^{-1}A M − 1 A M − 1 M^{-1} M − 1
如果2个空间都变基,那么变换T对应的新矩阵是 M − 1 A M M^{-1}AM M − 1 A M .而A的特征向量是基的一个非常好的选择,如果2个空间都选择特征向量作为基,这时变换对应的新矩阵为 S − 1 A S = Λ S^{-1}AS = \Lambda S − 1 A S = Λ
当基是由特征向量 x 1 . . . x n x_1...x_n x 1 ... x n Λ \Lambda Λ (sp:注意这里输入、输出基都是同一组基:特征向量!)
原因 :为了得到矩阵的第1列,首先输入第一个基向量 x 1 x_1 x 1 A x 1 = λ x 1 Ax_1 = \lambda x_1 A x 1 = λ x 1 λ 1 \lambda_1 λ 1 ( λ 1 , 0... , 0 ) (\lambda_1,0...,0) ( λ 1 , 0... , 0 ) 以特征向量为基,线性变换的矩阵是对角的
例1 把向量投影到直线 y= -x上,向量(1,0)投影为 (.5,-.5);而 (0,1) 投影为 (-.5,.5)。如果使用标准基,那么这个投影变换对应的矩阵就是:
1.Standard matrix: Project standard basis : A = [ .5 − .5 − .5 .5 ] \text{1.Standard matrix: Project standard basis} :\quad A = \left[\begin{matrix} .5 & -.5 \\ -.5 & .5 \end{matrix} \right] 1.Standard matrix: Project standard basis : A = [ .5 − .5 − .5 .5 ] 现在,使用特征向量基,会得到什么样的对角的 Λ \Lambda Λ x 1 = ( 1 , − 1 ) , x 2 = ( 1 , 1 ) x_1= (1,-1),x_2 = (1,1) x 1 = ( 1 , − 1 ) , x 2 = ( 1 , 1 ) λ 1 = 1 , λ 2 = 0 \lambda_1 = 1,\lambda_2 = 0 λ 1 = 1 , λ 2 = 0
x 1 x_1 x 1 135 ∘ 135^{\circ} 13 5 ∘ x 1 x_1 x 1 x 2 x_2 x 2 x 1 x_1 x 1 45 ∘ 45^{\circ} 4 5 ∘ 0 ⃗ \vec{0} 0
所以使用特征向量做投影的矩阵
2 Diagonalized matrix: Project eigenvectors: Λ = [ 1 0 0 0 ] \text{2 Diagonalized matrix: Project eigenvectors:} \quad \Lambda =\left[\begin{matrix} 1 & 0 \\ 0 & 0 \end{matrix} \right] 2 Diagonalized matrix: Project eigenvectors: Λ = [ 1 0 0 0 ] 现在如果使用新的基 v 1 = w 1 = ( 2 , 0 ) , v 2 = w 2 = ( 1 , 1 ) v_1= w_1 = (2,0),v_2 = w_2 = (1,1) v 1 = w 1 = ( 2 , 0 ) , v 2 = w 2 = ( 1 , 1 )
w 1 w_1 w 1 <#2> 所讲的方法:矩阵的列 j 是通过把变换 T ( v j ) T(v_j) T ( v j )
把 T 应用到 v 1 = ( 2 , 0 ) v_1=(2,0) v 1 = ( 2 , 0 ) (1,-1),也就是 w 1 − w 2 w_1- w_2 w 1 − w 2 1,-1
把 T 应用到 v 2 = ( 1 , 1 ) v_2=(1,1) v 2 = ( 1 , 1 ) (0,0),所以B的列2是 (0,0)
所以
3. Third similar matrix: Project w 1 and w 2 : B = [ 1 0 − 1 0 ] (1) \text{3. Third similar matrix: Project }w_1\text{ and } w_2 : \quad
B = \left[\begin{matrix} 1 & 0 \\ -1 & 0 \end{matrix} \right] \tag{1} 3. Third similar matrix: Project w 1 and w 2 : B = [ 1 − 1 0 0 ] ( 1 ) 还有一种更精妙的方法求B矩阵:使用 W , W − 1 W,W^{-1} W , W − 1 变基矩阵代表着恒等变换 !变换的乘积是 I T I ITI I T I
sp:这个I代表恒等变换,由W矩阵表示,也就是发生变基操作
而矩阵的乘积就是 B = W − 1 A W B=W^{-1}AW B = W − 1 A W
对任何基 w 1 . . . w n w_1...w_n w 1 ... w n
使用W将输入基变为标准基(
而标准基下变换对应的矩阵是A
使用 W − 1 W^{-1} W − 1
那么, B = W − 1 A W B = W^{-1} AW B = W − 1 A W ITI:
> B w’s to w’s = W standard to w’s − 1 A standard W w’s to standard > (2) > B_{\text{w's to w's}} = W^{-1}_{\text{standard to w's}} \quad A_{\text{standard}} \quad W_{\text{w's to standard}} \tag{2}
> > B w’s to w’s = W standard to w’s − 1 A standard W w’s to standard > ( 2 )
sp:注意:
第1步其实就是<Lk1.2> Eq(K3):先将输入基切换到标准基
第2步是用标准基下的变换矩阵A进行变换
第3步是<Lk1.2> Eq(K4),将输出基再次切换回去
整个过程其实就是 <#Lk1.3>的Eq(K7)!而Eq(k7)的推导,是同一个空间下的变基,所以本节也是同一个空间下的变基!
一个变基过程,产生了矩阵当中的相似变换 W − 1 A W W^{-1}AW W − 1 A W W − 1 A W W^{-1}AW W − 1 A W
例2 继续例1,使用 W − 1 A W W^{-1}AW W − 1 A W (2,0),(1,1) 是W的列
解:
W − 1 A W = [ 1 2 − 1 2 0 1 ] [ 1 2 − 1 2 − 1 2 1 2 ] [ 2 1 0 1 ] = [ 1 0 − 1 0 ] . W ^ { - 1 } A W = \left[ \begin{array} { r r } \frac { 1 } { 2 } & - \frac { 1 } { 2 } \\ 0 & 1 \end{array} \right] \left[ \begin{array} { r r } \frac { 1 } { 2 } & - \frac { 1 } { 2 } \\ - \frac { 1 } { 2 } & \frac { 1 } { 2 } \end{array} \right] \left[ \begin{array} { l l } 2 & 1 \\ 0 & 1 \end{array} \right] = \left[ \begin{array} { r r } 1 & 0 \\ - 1 & 0 \end{array} \right] . W − 1 A W = [ 2 1 0 − 2 1 1 ] [ 2 1 − 2 1 − 2 1 2 1 ] [ 2 0 1 1 ] = [ 1 − 1 0 0 ] . 这和 Eq(1) 的矩阵B是一样的,矩阵AB是相似的,它们有相同的特征值(1,0),而且 Λ \Lambda Λ
注意一下,投影矩阵还是有性质 A 2 = A , B 2 = B , Λ 2 = Λ A^2 = A,B^2 = B,\Lambda^2 = \Lambda A 2 = A , B 2 = B , Λ 2 = Λ
V32-2:其实讲的就是同一个变换T对应的矩阵,在同一空间下不同基的联系,也就是相似矩阵!还是<#Lk1.3>的内容!
现在回到数学上面来.基表换,就一个基上的向量,想要变换成不同基上的向量.假设W的列是新的基向量,1个旧基向量下的x,转换成新基向量下的c,关系就是
x old basis = W c new basis (F4) x_{\text{old basis}} = Wc_{\text{new basis}} \tag{F4} x old basis = W c new basis ( F4 ) 矩阵W给出了一个基变换.
假设已知线性变换T(是对于n-n矩阵),假设其是从8维空间到8维空间的变换.现在引入矩阵。
第一组基, v 1 − v 8 v_1-v_8 v 1 − v 8
第二组基,w 1 − w 8 w_1-w_8 w 1 − w 8
那么A,B之间是什么关系呢?变换T是已知的,比如旋转。不管线性变换是什么,我们得知道,AB表示同一个变换T,AB之间肯定有某种联系。它们是相似的!也就是说:
B = M − 1 A M (F5) B = M^{−1} AM \tag{F5} B = M − 1 A M ( F5 ) M就是变基矩阵(change of basis matrix).发生基变换,会发生2件事情
每个向量都有了新坐标,也就是 Eq(F4),这就是新旧坐标之间的关系.
不同基的下的同一个变换对应的矩阵不一样,它们的联系就是Eq(F5),其中 Eq(F5)当中的M,就是 Eq(F4) 的W (sp:M,W就是Eq(K7)的C啊)
如果输入基 v 1 . . . v n v_1...v_n v 1 ... v n u 1 . . . u m u_1...u_m u 1 ... u m R n R^n R n R m R^m R m Σ \Sigma Σ 一个 输入向量 v j v_j v j u j u_j u j Σ \Sigma Σ σ j \sigma_j σ j
A v j = { σ j u j for j ≤ r 0 for j > r with orthonormal bases. (3) A v _ { j } = \left\{ \begin{array} { l l } \sigma _ { j } u _ { j } & \text { for } j \leq r \\ 0 & \text { for } j > r \end{array} \quad \right. \text { with orthonormal bases. }
\tag{3} A v j = { σ j u j 0 for j ≤ r for j > r with orthonormal bases. ( 3 ) 奇异值的排序是 σ 1 ≥ σ 2 ≥ . . . σ r \sigma_1 \ge \sigma_2 \ge ... \sigma_r σ 1 ≥ σ 2 ≥ ... σ r j = r + 1... n j=r+1...n j = r + 1... n v j v_j v j
现在把矩阵和它们所代表的线性变换联系起来。A , Σ A,\Sigma A , Σ
A = U Σ V T A = U\Sigma V^T A = U Σ V T R n , R m R^n,R^m R n , R m 对角的 Σ \Sigma Σ
正交矩阵V,U导致了基的改变,它们代表 R n , R m R^n,R^m R n , R m ITI,这个变换由v's和u's的基的 Σ = U − 1 A V \Sigma = U^{-1}AV Σ = U − 1 A V
v's和u's的基下的 Σ \Sigma Σ U − 1 A V U^{-1}AV U − 1 A V
Σ v’s to u’s = U standard to u’s − 1 A standard V v’s to standard (4) \Sigma_{\text{v's to u's}} = U^{-1}_{\text{standard to u's}} \quad A_{\text{standard}} \quad V_{\text{v's to standard}} \tag{4} Σ v’s to u’s = U standard to u’s − 1 A standard V v’s to standard ( 4 )
sp:这其实就是:1:乘以V矩阵得到AV,将输入基从v's变换到标准基; 2:用标准基下的A做变换;3:U − 1 U^{-1} U − 1
SVD选择了标准正交基 (U − 1 = U T , V − 1 = V T U^{-1} = U^T,V^{-1} = V^T U − 1 = U T , V − 1 = V T
SVD下的2组标准正交基来自于 A T A A^TA A T A A A T AA^T A A T σ j 2 \sigma_j^2 σ j 2 <01-06 #7> 的Eq(10),Eq(11)证明了这些基可以把标准基下的A化为 Σ \Sigma Σ
sp:注意这一小节的意思,是说,标准基下的变换对应的矩阵是A,但如果把输入基变为 v's,输出基变为 u's,那么变换对应的矩阵就是对角的 Σ \Sigma Σ
Polar decomposition
完全不知道这节在干啥
每个复数都有极坐标形式 r e i θ re^{i\theta} r e i θ ∣ e i θ ∣ = ∣ cos θ + i sin θ ∣ = 1 |e^{i\theta}| = |\cos \theta + i \sin \theta | = 1 ∣ e i θ ∣ = ∣ cos θ + i sin θ ∣ = 1
r ≥ 0 r\ge 0 r ≥ 0 e i θ e^{i\theta} e i θ
极坐标分解把这个因子分解扩展到了矩阵:正交 * 半正定:A = QH
每一个实数方阵,都可以分解为 A = Q H A= QH A = Q H
Q是正交矩阵
H是对称半正定矩阵(如果A是可逆的,H正定)
证明只需要将 V T V = I V^TV = I V T V = I
Polar decomposition: A = U Σ V T = ( U V T ) ( V Σ V T ) = ( Q ) ( H ) . (5) \text{Polar decomposition:}\quad A = U \Sigma V ^ { \mathrm { T } } = \left( U V ^ { \mathrm { T } } \right) \left( V \Sigma V ^ { \mathrm { T } } \right) = ( Q ) ( H ) .
\tag{5} Polar decomposition: A = U Σ V T = ( U V T ) ( V Σ V T ) = ( Q ) ( H ) . ( 5 ) 第1个因子 U V T UV^T U V T V Σ V T V\Sigma V^T V Σ V T Σ \Sigma Σ Σ , H \Sigma,H Σ , H 对称正定矩阵,等于 A T A A^TA A T A H 2 = V Σ 2 V T = A T A H^2 = V\Sigma^2V^T = A^TA H 2 = V Σ 2 V T = A T A
极坐标还有另外一种形式:A = KQ,Q还是正交的,但 K = U Σ U T K=U\Sigma U^T K = U Σ U T A A T AA^T A A T
例3 求如下 <01-06 #7> 出现过的SVD的 A = QH的极坐标分解
A = [ 2 2 − 1 1 ] = [ 0 1 1 0 ] [ 2 2 2 ] [ − 1 / 2 1 / 2 1 / 2 1 / 2 ] = U Σ V T A = \left[ \begin{array} { r r } 2 & 2 \\ - 1 & 1 \end{array} \right] = \left[ \begin{array} { l l } 0 & 1 \\ 1 & 0 \end{array} \right] \left[ \begin{array} { l l } \sqrt { 2 } & \\ & 2 \sqrt { 2 } \end{array} \right] \left[ \begin{array} { r r } - 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \\ 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \end{array} \right] = U \Sigma V ^ { \mathrm { T } } A = [ 2 − 1 2 1 ] = [ 0 1 1 0 ] [ 2 2 2 ] [ − 1/ 2 1/ 2 1/ 2 1/ 2 ] = U Σ V T 解:
Orthogonal Q = U V T = [ 0 1 1 0 ] [ − 1 / 2 1 / 2 1 / 2 1 / 2 ] = [ 1 / 2 1 / 2 − 1 / 2 1 / 2 ] Positive definite H = V Σ V T = [ 1 / 2 − 1 / 2 1 / 2 1 / 2 ] [ 2 2 − 1 1 ] = [ 3 / 2 1 / 2 1 / 2 3 / 2 ] . \begin{array} { l l } \text { Orthogonal } & Q =UV^T= \left[ \begin{array} { l l } 0 & 1 \\ 1 & 0 \end{array} \right] \left[ \begin{array} { r r } - 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \\ 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \end{array} \right] = \left[ \begin{array} { r r } 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \\ - 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \end{array} \right] \\
\text { Positive definite } & H =V\Sigma V^T= \left[ \begin{array} { l r } 1 / \sqrt { 2 } & - 1 / \sqrt { 2 } \\ 1 / \sqrt { 2 } & 1 / \sqrt { 2 } \end{array} \right] \left[ \begin{array} { r r } 2 & 2 \\ - 1 & 1 \end{array} \right] = \left[ \begin{array} { l l } 3 / \sqrt { 2 } & 1 / \sqrt { 2 } \\ 1 / \sqrt { 2 } & 3 / \sqrt { 2 } \end{array} \right] . \end{array} Orthogonal Positive definite Q = U V T = [ 0 1 1 0 ] [ − 1/ 2 1/ 2 1/ 2 1/ 2 ] = [ 1/ 2 − 1/ 2 1/ 2 1/ 2 ] H = V Σ V T = [ 1/ 2 1/ 2 − 1/ 2 1/ 2 ] [ 2 − 1 2 1 ] = [ 3/ 2 1/ 2 1/ 2 3/ 2 ] . 注意,H = Q − 1 A = Q T A H = Q^{-1}A = Q^TA H = Q − 1 A = Q T A
在力学(mechanics)当中,极坐标分解把Q当中的旋转(rotation)和H当中的伸展(stretching)分离开来。H的特征值是A的奇异秩,它们给出了伸展因子(stretching factor)。H的特征向量是 A T A A^TA A T A
极坐标分解把关键等式 A v i = σ i u i Av_i = \sigma_i u_i A v i = σ i u i
H部分把 σ i \sigma_i σ i v i v_i v i
The"Q" part swings v i v_i v i u i u_i u i
The Pseudoinverse
在<01-02>,我们学习,双边逆的意思是 A A − 1 = I = A − 1 A AA^{-1} = I = A^{-1}A A A − 1 = I = A − 1 A
在<01-03>,我们开始讨论矩阵不满秩的情况:
当列满秩,列向量线性无关,r=n,这时候零空间只有0向量,Ax=b有0或1个解,此时 A T A A^TA A T A
( A T A ) − 1 A T ⏟ A l e f t − 1 A = I [ n − m ] ∗ [ m − n ] = [ n − n ] \underbrace{(A^TA)^{-1} A^T}_{\quad \color{orange} A^{-1}_{left}} A = I
\\
[n-m ] * [m-n] = [n-n] A l e f t − 1 ( A T A ) − 1 A T A = I [ n − m ] ∗ [ m − n ] = [ n − n ] 但注意 A A T AA^T A A T ( A T A ) − 1 A T (A^TA)^{-1} A^T ( A T A ) − 1 A T A ∗ ( A T A ) − 1 A T A * (A^TA)^{-1} A^T A ∗ ( A T A ) − 1 A T <01-04 #2.2> Eq(7))!是列空间的投影。一个投影矩阵,会尽量靠近单位矩阵!它的投影结果想尽可能的接近列空间!
当行满秩,行向量线性无关,r=m,这时候 A T A^T A T
A A T ( A A T ) − 1 ⏟ A r i g h t − 1 = I A\underbrace{A^T(AA^T)^{-1}}_{\quad \color{orange} A^{-1}_{right}} = I A A r i g h t − 1 A T ( A A T ) − 1 = I 如果此时把右逆 A T ( A A T ) − 1 A^T(AA^T)^{-1} A T ( A A T ) − 1 A T ( A A T ) − 1 ∗ A A^T(AA^T)^{-1} * A A T ( A A T ) − 1 ∗ A
sp:为什么右逆放在左边是投影到行空间呢?注意观察:A T ( A A T ) − 1 ∗ A A^T(AA^T)^{-1} * A A T ( A A T ) − 1 ∗ A A T A^T A T B ( B T B ) − 1 ∗ B T B(B^TB)^{-1} * B^T B ( B T B ) − 1 ∗ B T <01-04 #2.2> Eq(7)啊,只是现在B代表A T A^T A T
V33-2 :左、右逆是列、行满秩的时候才能出现。一般情况下,对r<n,r<m 的一个常规矩阵来说,它合理逆是什么呢?
行空间的一个向量x有n个分量,A乘以它,也就是Ax,结果是列空间的向量。而且,A乘以行空间的所有 向量,得到的恰好就是列空间的所有 向量。也就是,行空间的向量x,和列空间的向量Ax,是一一对应的。 (最起码,因为行列空间都是r维,所以这个可能性是存在的)。而且,矩阵A有零空间存在,Ax将产生0向量,而所有的向量都是与行空间分量+零空间分量组成的,乘法Ax会消去零空间分量。而当我们只看行空间向量,Ax乘法会把它们变换到列空间向量。我这里的意思是:
Mark1:x,y是行空间的不同 向量,和A乘得到Ax,Ay. Ax和Ay肯定是不同 的列空间 向量.
从行空間到列空間,A是完美的映射。換句話說,如果限制在這2個r维空間,A是可逆的 (sp:因爲是單射啊),这就是所謂的伪逆。也就是说:
从行空间的x到列空间的Ax,矩阵A起作用,A消除了x向量的零空间部分
从列空间空间的Ax回到行空间的x,矩阵A + A^+ A + x = A + ( A x ) x= A^+(Ax) x = A + ( A x ) A + A^+ A + A T A^T A T
证明 :假设 Mark1这句话是错误的,也就是 Ax= Ay,会发生什么?也就是 A ( x − y ) = 0 A(x-y)= 0 A ( x − y ) = 0
所以矩阵A A A 可逆 映射。它的逆叫做伪逆。那么如何求出伪逆 A + A^+ A + SVD!
在SVD当中,有 A = U Σ V T A = U\Sigma V^T A = U Σ V T Σ \Sigma Σ
> Σ = [ σ 1 ⋱ σ r 0 > > > ⋱ ] > > \Sigma = \left[ \begin{array} { c c c c c} \sigma _ { 1 } & & & & \\ & \ddots & & & \\ & & \sigma _ { r } &\\ & & & 0
> & \\
>
> & & & & \ddots\end{array} \right]
> > Σ = σ 1 >> ⋱ σ r 0 > ⋱ >
现在问你,m-n Σ \Sigma Σ
> Σ + = [ > > 1 / σ 1 ⋱ 1 / σ r 0 > > > ⋱ ] > > \Sigma^+ = \left[ \begin{array} { c c c c c}
>
> 1/\sigma _ { 1 } & & & & \\ & \ddots & & & \\ & & 1/\sigma _ { r } &\\ & & & 0
> & \\
>
> & & & & \ddots\end{array} \right]
> > Σ + = >> 1/ σ 1 >> ⋱ 1/ σ r 0 > ⋱ >
注意它的尺寸是 n-m 。现在看看
> Σ Σ + = > [ > > 1 ⋱ 1 0 > > > ⋱ ] m − m > > \Sigma \Sigma^+ =
> \left[ \begin{array} { c c c c c}
>
> 1 & & & & \\ & \ddots & & & \\ & & 1 &\\ & & & 0
> & \\
>
> & & & & \ddots\end{array} \right]_{m-m}
> > Σ Σ + => >> 1 >> ⋱ 1 0 > ⋱ m − m >
这是到列空间的投影 。而
> Σ + Σ = > [ > > 1 ⋱ 1 0 > > > ⋱ ] n − n > > \Sigma^+ \Sigma =
> \left[ \begin{array} { c c c c c}
>
> 1 & & & & \\ & \ddots & & & \\ & & 1 &\\ & & & 0
> & \\
>
> & & & & \ddots\end{array} \right]_{n-n}
> > Σ + Σ => >> 1 >> ⋱ 1 0 > ⋱ n − n >
这是到行空间的投影 。
这就是伪逆所做的事情:左乘,右乘它,虽然都得不到单位矩阵,但它把你代入2个很好的空间:行空间和列空间
现在回到 A = U Σ V T A = U\Sigma V^T A = U Σ V T
V T V^T V T Σ \Sigma Σ Σ + \Sigma^+ Σ + U的逆是 U T U^T U T
所以 A + = V Σ + U T A^+ = V\Sigma^+U^T A + = V Σ + U T
通过选择合适的基,A乘以行空间当中的v i v_i v i σ i u i \sigma_i u_i σ i u i 特殊的 A + A^{+} A + A v = σ u Av = \sigma u A v = σ u A + u = v / σ A^{+} u= v/\sigma A + u = v / σ A + A^{+} A + 1 / σ 1/\sigma 1/ σ A − 1 A^{-1} A − 1 1 / λ 1/\lambda 1/ λ
这个乘以 u i u_i u i v i / σ i v_i/\sigma_i v i / σ i A + A^+ A +
A n by m + = V Σ + U T = [ v 1 ⋯ v r ⋯ v n ] ⏟ n by n [ σ 1 − 1 ⋱ σ r − 1 0 ] ⏟ n by m [ u 1 ⋯ u r ⋯ u m ] T ⏟ m by m Pseudoinverse A^+_{\text{n by m}} = V\Sigma^+U^T =
\underbrace{ \left[ v _ { 1 } \cdots v _ { r } \cdots v _ { n } \right] }_{\text{n by n}}
\underbrace{ \left[ \begin{array} { c c c } \sigma _ { 1 } ^ { - 1 } & & &\\ & \ddots & &\\ & & \sigma _ { r } ^ { - 1 } & \\ & & & 0\end{array} \right] }_{\text{n by m}}
\underbrace{ \left[ u _ { 1 } \cdots u _ { r } \cdots u _ { m } \right] ^ { \mathrm { T } }}_{\text{m by m}}
\qquad \color{orange} \text{Pseudoinverse} A n by m + = V Σ + U T = n by n [ v 1 ⋯ v r ⋯ v n ] n by m σ 1 − 1 ⋱ σ r − 1 0 m by m [ u 1 ⋯ u r ⋯ u m ] T Pseudoinverse
如果A可逆( A − 1 A^{-1} A − 1 A + A^+ A + A − 1 A^{-1} A − 1 U Σ V T U\Sigma V^T U Σ V T V Σ − 1 U T V\Sigma^{-1}U^T V Σ − 1 U T
而如果 r<m 或 r<n. 那么A没有双边逆,但它一定有秩为 r(和A一样) 的伪逆 A + A^+ A +
A + u i = 1 σ i v i for i ≤ r and A + u i = 0 ⃗ for i > r A ^ { + } \boldsymbol { u } _ { i } = \frac { 1 } { \sigma _ { i } } v _ { i } \quad \text { for } i \leq r \quad \text { and } \quad A ^ { + } { u } _ { i } = \vec { 0 } \quad \text { for } i > r A + u i = σ i 1 v i for i ≤ r and A + u i = 0 for i > r 被A乘后,A列空间当中的向量 u 1 . . . u r u_1...u_r u 1 ... u r v 1 . . . v r v_1...v_r v 1 ... v r u r + 1 . . . u m u_{r+1}...u_m u r + 1 ... u m A + A^+ A + u i u_i u i A + A^+ A +
注意对角矩阵 Σ \Sigma Σ Σ + \Sigma^+ Σ + Σ \Sigma Σ σ \sigma σ σ − 1 \sigma^{-1} σ − 1 Σ + Σ \Sigma^+\Sigma Σ + Σ I,部分是0),它有r个1,其他都是0.如下例子展示 σ 1 = 2 , σ 2 = 3 \sigma_1 = 2,\sigma_2 =3 σ 1 = 2 , σ 2 = 3
Σ + Σ = [ 1 / 2 0 0 0 1 / 3 0 0 0 0 ] [ 2 0 0 0 3 0 0 0 0 ] = [ 1 0 0 0 1 0 0 0 0 ] = [ I 0 0 0 ] . \Sigma ^ { + } \Sigma = \left[ \begin{array} { c c c } 1 / 2 & 0 & 0 \\ 0 & 1 / 3 & 0 \\ 0 & 0 & 0 \end{array} \right] \left[ \begin{array} { l l l } 2 & 0 & 0 \\ 0 & 3 & 0 \\ 0 & 0 & 0 \end{array} \right] = \left[ \begin{array} { l l l } 1 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & 0 & 0 \end{array} \right] = \left[ \begin{array} { l l } I & 0 \\ 0 & 0 \end{array} \right] . Σ + Σ = 1/2 0 0 0 1/3 0 0 0 0 2 0 0 0 3 0 0 0 0 = 1 0 0 0 1 0 0 0 0 = [ I 0 0 0 ] . 伪逆是 n-m 的矩阵,它让 A A + , A + A AA^+,A^+A A A + , A + A
sp:mark7.3-1
A A + AA^+ A A + A + A A^+A A + A
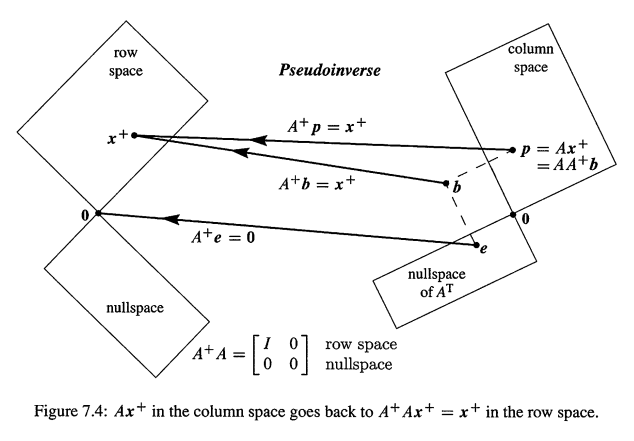
sp:Fig7.4什么意思?首先要明白A的作用,下图来自 <01-04 #1> Fig4.2
A的作用是
将行空间的向量 x r x_r x r
将行空间的向量 x n x_n x n
而任何向量 R n R^n R n <01-04 #2>)).所以A作用是将任何 R n R^n R n R m R^m R m
在Fig7.4当中,列空间和A T A^T A T A T A^T A T
投影p在列空间,可由矩阵A乘以行空间的 x + x^+ x + p = A x + p = Ax^+ p = A x +
而伪逆A + A^+ A + A + p = x + A^+p = x^+ A + p = x +
A + b = x + A^+b = x^+ A + b = x + A + A^+ A + A T A^T A T
但 sp:mark7.3-1 怎么理解?真的有点难以理解,参见
https://math.stackexchange.com/questions/3025109/projection-matrices-mathbfa-mathbfa-and-mathbfa-mathbfa
https://math.stackexchange.com/questions/2209379/singular-value-decomposition-proof/2211001#2211001
https://en.m.wikipedia.org/wiki/Moore%E2%80%93Penrose_inverse#Projectors
https://math.stackexchange.com/questions/578376/least-square-with-homogeneous-solution?noredirect=1&lq=1
https://math.stackexchange.com/questions/3888531/prove-aa-projects-onto-the-column-space-of-a
例4 求r=1,不可逆矩阵 A = [ 2 2 1 1 ] A = \left[\begin{matrix} 2 & 2 \\ 1 & 1 \end{matrix} \right] A = [ 2 1 2 1 ] 10 \sqrt{10} 10 Σ + \Sigma^+ Σ + 1 / 10 1/\sqrt{10} 1/ 10
A + = V Σ + U T = 1 2 [ 1 1 1 − 1 ] [ 1 / 10 0 0 0 ] 1 5 [ 2 1 1 − 2 ] = 1 10 [ 2 1 2 1 ] A ^ { + } = V \Sigma ^ { + } U ^ { \mathrm { T } } = \frac { 1 } { \sqrt { 2 } } \left[ \begin{array} { r r } 1 & 1 \\ 1 & - 1 \end{array} \right] \left[ \begin{array} { c c } 1 / \sqrt { 10 } & 0 \\ 0 & 0 \end{array} \right] \frac { 1 } { \sqrt { 5 } } \left[ \begin{array} { r r } 2 & 1 \\ 1 & - 2 \end{array} \right] = \frac { 1 } { 10 } \left[ \begin{array} { l l } 2 & 1 \\ 2 & 1 \end{array} \right] A + = V Σ + U T = 2 1 [ 1 1 1 − 1 ] [ 1/ 10 0 0 0 ] 5 1 [ 2 1 1 − 2 ] = 10 1 [ 2 2 1 1 ] A + A^+ A + A + A^+ A + A + ( 4 , 2 ) = ( 1 , 1 ) A^+(4,2) = (1,1) A + ( 4 , 2 ) = ( 1 , 1 )
任何秩1矩阵都是一列乘以一行。对于单位向量 u , v u,v u , v A = σ u v T A = \sigma uv^T A = σ u v T A + = v u T / σ A^+ = vu^T/\sigma A + = v u T / σ A A + AA^+ A A + u u T uu^T u u T u的直线上;乘积 A + A A^+A A + A v v T vv^T v v T
在 <01-02>,我们通过最小二乘,探讨了在 Ax = b无解的情况下,求得一个最佳解 x ^ \hat{x} x ^ A T A x ^ = A T b A^TA\hat{x} = A^Tb A T A x ^ = A T b A T A A^TA A T A
如果A有非独立的列(r<n),那么 A T A x ^ = A T b A^TA\hat{x} = A^Tb A T A x ^ = A T b 最佳的解就是来自于伪逆的 x + = A + b x^+ = A^+b x + = A + b 可以检查一下:A T A A + b = A T b A^TAA^+b = A^Tb A T A A + b = A T b e = b − A A + b e = b - AA^+b e = b − A A + b A T A^T A T x + x^+ x + A T A x ^ = A T b A^TA\hat{x} = A^Tb A T A x ^ = A T b 额外 一个解,但 x + x^+ x + x ^ \hat{x} x ^ Ax =b 的最短的最小二乘解是 x + = A + b x^+ = A^+b x + = A + b
伪逆 A + A^+ A + x + x^+ x +
这就是SVD的神奇之处!
对角化 S − 1 A S = Λ S^{-1}AS = \Lambda S − 1 A S = Λ
SVD选择v's作为输入基,u's作为输出基,这些标准正交的基对角化了A,也就是 A v i = σ i u i Av_i = \sigma_i u_i A v i = σ i u i A = U Σ V T A = U\Sigma V^T A = U Σ V T
极坐标分解把A分解为QH,也就是旋转的 U V T UV^T U V T V Σ V T V\Sigma V^T V Σ V T
伪逆 A + = V Σ + U T A^+ = V\Sigma^+U^T A + = V Σ + U T A + A A^+A A + A
1.
如果A列满秩(r=n),那么它有一个左逆 C = ( A T A ) − 1 A T C = (A^TA)^{-1}A^T C = ( A T A ) − 1 A T C A = I CA = I C A = I A + = C A^+= C A + = C
如果A行满秩(r=m),那么它有一个右逆 B = A T ( A A T ) − 1 B = A^T(AA^T)^{-1} B = A T ( A A T ) − 1 A B = I AB = I A B = I A + = B A^+= B A + = B
对于如下矩阵,求A 1 A_1 A 1 A 2 A_2 A 2 A 1 , A 2 , A 3 A_1,A_2,A_3 A 1 , A 2 , A 3 A + A^+ A +
A 1 = [ 2 2 ] A 2 = [ 2 2 ] A 3 = [ 2 2 2 2 ] A _ { 1 } = \left[ \begin{array} { l } 2 \\ 2 \end{array} \right] \quad A _ { 2 } = \left[ \begin{array} { l l } 2 & 2 \end{array} \right] \quad A _ { 3 } = \left[ \begin{array} { l l } 2 & 2 \\ 2 & 2 \end{array} \right] A 1 = [ 2 2 ] A 2 = [ 2 2 ] A 3 = [ 2 2 2 2 ] 解:如果A列满秩,那么 A T A A^TA A T A <01-04 #2>),那么,明显的,C A = ( A T A ) − 1 A T ∗ A = I CA = (A^TA)^{-1}A^T * A = I C A = ( A T A ) − 1 A T ∗ A = I A C = A ∗ ( A T A ) − 1 A T AC = A*(A^TA)^{-1}A^T A C = A ∗ ( A T A ) − 1 A T <01-04 #2> 知识点。所以C满足了A + A^+ A +
如果A行满秩,那么 A A T AA^T A A T A B = A ∗ A T ( A A T ) − 1 = I AB = A * A^T(AA^T)^{-1} = I A B = A ∗ A T ( A A T ) − 1 = I B A = A T ( A A T ) − 1 ∗ A BA = A^T(AA^T)^{-1} * A B A = A T ( A A T ) − 1 ∗ A
A 1 + = ( A 1 T A 1 ) − 1 A 1 T = 1 8 [ 2 2 ] A 2 + = A 2 T ( A 2 A 2 T ) − 1 = 1 8 [ 2 2 ] \boldsymbol { A } _ {1} ^ { + } = \left( A _ { 1 } ^ { \mathrm { T } } A _ { 1 } \right) ^ { - 1 } A _ { 1 } ^ { \mathrm { T } } = \frac { 1 } { \sqrt { 8 } } \left[ \begin{array} { l l } 2 & 2 \end{array} \right] \quad A _ { 2 } ^ { + } = A _ { 2 } ^ { \mathrm { T } } \left( A _ { 2 } A _ { 2 } ^ { \mathrm { T } } \right) ^ { - 1 } = \frac { 1 } { \sqrt { 8 } } \left[ \begin{array} { l } 2 \\ 2 \end{array} \right] A 1 + = ( A 1 T A 1 ) − 1 A 1 T = 8 1 [ 2 2 ] A 2 + = A 2 T ( A 2 A 2 T ) − 1 = 8 1 [ 2 2 ] 注意 A 1 + A 1 = [ 1 ] , A 2 A 2 + = [ 1 ] A_1^+A_1= [1],A_2A_2^+ = [1] A 1 + A 1 = [ 1 ] , A 2 A 2 + = [ 1 ] A 3 A_3 A 3 A 3 + = σ 1 − 1 v 1 u 1 T = [ 1 1 1 1 ] / 4 A_3^+ = \sigma _ { 1 } ^ { - 1 } v _ { 1 } u _ { 1 } ^ { \mathrm { T } } = \left[ \begin{array} { l l } 1 & 1 \\ 1 & 1 \end{array} \right] / 4 A 3 + = σ 1 − 1 v 1 u 1 T = [ 1 1 1 1 ] /4
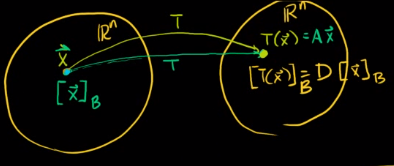
线性变换的概念不复杂,但是一定要理清楚是什么意思。特别是对于
等需要搞清楚概念。本节导入摘抄 可汗学院 等知识点,和自己的一些理解,方便后文理解阅读
coordinate with respct to a basis
设V是 R n R^n R n B = { v 1 . . . v k } B=\{v_1...v_k\} B = { v 1 ... v k } k最大是n,但可能比n小 。 所以,任何 a ⃗ ∈ V \vec{a} \in V a ∈ V
a ⃗ ∈ V = c 1 v 1 ⃗ + . . . + c k v k ⃗ = [ ∣ ∣ v 1 … v k ∣ ∣ ] ⏟ 基矩阵C [ c 1 ⋮ c k ] (K1) \vec{a} \in V = c_1\vec{v_1}+...+ c_k \vec{v_k}
=
\underbrace{
\left[ \begin{array}{c} | & & | \\
v_1 & \dots & v_k
\\
| & & |
\end{array} \right]
}_{\color{orange}\text{基矩阵C}}
\left[ \begin{array}{c} c_1 \\ \vdots \\ c_k\end{array} \right]
\tag{K1} a ∈ V = c 1 v 1 + ... + c k v k = 基矩阵 C ∣ v 1 ∣ … ∣ v k ∣ c 1 ⋮ c k ( K1 ) 现在 c 1 . . . c k c_1...c_k c 1 ... c k 向量 a 在基B下的坐标(coordinate of a with respect to B) ,并且这个坐标写成 :
[ a ⃗ ] B = [ c 1 ⋮ c k ] (K2) [\vec{a}]_B = \left[ \begin{array}{c} c_1 \\
\vdots \\ c_k\end{array} \right]
\tag{K2} [ a ] B = c 1 ⋮ c k ( K2 ) 设 v 1 ⃗ = [ 2 1 ] , v 2 ⃗ = [ 1 2 ] \vec{v_1} = \left[ \begin{array}{c} 2 \\1\end{array} \right],\vec{v_2} = \left[ \begin{array}{c} 1 \\2\end{array} \right] v 1 = [ 2 1 ] , v 2 = [ 1 2 ] B = { v 1 , v 2 } B= \{v_1,v_2\} B = { v 1 , v 2 } R 2 R^2 R 2 a ⃗ = 3 v 1 + 2 v 2 = [ 8 7 ] \vec{a} = 3v_1 + 2v_2 = \left[ \begin{array}{c} 8 \\7\end{array} \right] a = 3 v 1 + 2 v 2 = [ 8 7 ]
但此时,a在基B下的坐标是 [ a ] B = [ 3 2 ] [a]_B = \left[ \begin{array}{c} 3 \\2\end{array} \right] [ a ] B = [ 3 2 ] v 1 v_1 v 1 v 2 v_2 v 2 (8,7) 位置.
以前我们说的坐标,都隐含是关于标准基的,,在标准基下的坐标也成为标准坐标(standard coordinate) ,现在有不同的基,而且不同的基下,同一个向量的坐标不一样. 向量 a,在标准基下直接写为 a ⃗ \vec{a} a 在基B下写为 [ a ⃗ ] B [\vec{a}]_B [ a ] B .
change of basis ,change of basis matrix
现在思考,假设给出了 Eq(K2) 的 [ a ⃗ ] B [\vec{a}]_B [ a ] B Eq(K1) 的C矩阵).那么怎么得到在标准基下的坐标 a ⃗ \vec{a} a Eq(K1) 的基矩阵C乘以 [ a ⃗ ] B [\vec{a}]_B [ a ] B
C [ a ⃗ ] B = a ⃗ (K3) C [\vec{a}]_B = \vec{a}
\tag{K3} C [ a ] B = a ( K3 ) 右边的 a ⃗ \vec{a} a 矩阵C称为变基矩阵(有的也叫转移矩阵,transition matrix) ! 听起来有点难以理解,其实C矩阵就是基B作为列的矩阵
分析一下Eq(K3)是怎么得来的。对于 R 2 R^2 R 2
v ⃗ = [ v 1 v 2 ] = v 1 [ 1 0 ] + v ⃗ 2 [ 0 1 ] = v 1 i ⃗ + v 2 j ⃗ \vec { v } = \left[ \begin{array} { l } v_1\\ v_2\end{array} \right]
= v_{ 1 } \left[ \begin{array} { l } 1 \\ 0 \end{array} \right] + \vec { v } _ { 2 } \left[ \begin{array} { l } 0 \\ 1 \end{array} \right]
= v _ { 1 } \vec { i } + v _ { 2 } \vec { j } v = [ v 1 v 2 ] = v 1 [ 1 0 ] + v 2 [ 0 1 ] = v 1 i + v 2 j 但 R 2 R^2 R 2 u ⃗ 1 = [ 1 2 ] u ⃗ 2 = [ 3 3 ] \begin{array} { c } \vec { u } _ { 1 } = \left[ \begin{array} { l } 1 \\ 2 \end{array} \right] \quad \vec { u } _ { 2 } = \left[ \begin{array} { l } 3 \\ 3 \end{array} \right] \end{array} u 1 = [ 1 2 ] u 2 = [ 3 3 ] v ⃗ = v 1 ′ u ⃗ 1 + v 2 ′ u ⃗ 2 \vec { v } = v _ { 1 } ^ { \prime } \vec { u } _ { 1 } + v _ { 2 } ^ { \prime } \vec { u } _ { 2 } v = v 1 ′ u 1 + v 2 ′ u 2 v 1 ′ , v 2 ′ v_1',v_2' v 1 ′ , v 2 ′ 新的基下的坐标 。 虽然变基了,但还是同一个向量 ,也就是说,如下2个等式相等
v 1 ′ u ⃗ 1 + v 2 ′ u ⃗ 2 = v 1 i ⃗ + v 2 j ⃗ (N1) v _ { 1 } ^ { \prime } \vec { u } _ { 1 } + v _ { 2 } ^ { \prime } \vec { u } _ { 2 } = v _ { 1 } \vec { i } + v _ { 2 } \vec { j }
\tag{N1} v 1 ′ u 1 + v 2 ′ u 2 = v 1 i + v 2 j ( N1 )
sp-note-N1:注意 Eq(N1) 就是 <sp-mark7.2-5> 处,变基矩阵定义的意思**。变基矩阵也是一种变换:恒等表换,但变换后,向量在标准基下的坐标是不变的**。
而新的基 u 1 , u 2 u_1,u_2 u 1 , u 2
u ⃗ 1 = 1 [ 1 0 ] + 2 [ 0 1 ] = 1 i ⃗ + 2 j ⃗ u ⃗ 2 = 3 [ 1 0 ] + 3 [ 0 1 ] = 3 i ⃗ + 3 j ⃗ \begin{array} { r }
\vec { u } _ { 1 } = 1\left[ \begin{array} { l } 1 \\ 0 \end{array} \right] + 2 \left[ \begin{array} { l } 0 \\ 1 \end{array} \right] = 1\vec { i } + 2 \vec { j} \\
\vec { u } _ { 2 } = 3 \left[ \begin{array} { l } 1 \\ 0 \end{array} \right] + 3 \left[ \begin{array} { l } 0 \\ 1 \end{array} \right] = 3 \vec { i } + 3 \vec { j }
\end{array} u 1 = 1 [ 1 0 ] + 2 [ 0 1 ] = 1 i + 2 j u 2 = 3 [ 1 0 ] + 3 [ 0 1 ] = 3 i + 3 j 现在,把上式代入 Eq(N1):
v 1 ′ u ⃗ 1 + v 2 ′ u ⃗ 2 = v 1 i ⃗ + v 2 j ⃗ ⇓ v 1 ′ ( i ⃗ + 2 j ⃗ ) + v 2 ′ ( 3 i ⃗ + 3 j ⃗ ) = v 1 i ⃗ + v 2 j ⃗ ⇓ (提取 i , j ) ( v 1 ′ + 3 v 2 ′ ) i ⃗ + ( 2 v 1 ′ + 3 v 2 ′ ) j ⃗ = v 1 ı ^ + v 2 j ⃗ v _ { 1 } ^ { \prime } \vec { u } _ { 1 } + v _ { 2 } ^ { \prime } \vec { u } _ { 2 } = v _ { 1 } \vec { i } + v _ { 2 } \vec { j} \\
\Downarrow\\
v _ { 1 } ^ { \prime } ( \vec { i } + 2 \vec { j } ) + v _ { 2 } ^ { \prime } ( 3 \vec { i } + 3 \vec { j } ) = v _ { 1 } \vec { i } + v _ { 2 }\vec{j} \\
\Downarrow(提取i,j)\\
\left( v _ { 1 } ^ { \prime } + 3 v _ { 2 } ^ { \prime } \right) \vec { i } + \left( 2 v _ { 1 } ^ { \prime } + 3 v _ { 2 } ^ { \prime } \right) \vec { j } = v _ { 1 } \hat { \imath } + v _ { 2 }\vec{j} v 1 ′ u 1 + v 2 ′ u 2 = v 1 i + v 2 j ⇓ v 1 ′ ( i + 2 j ) + v 2 ′ ( 3 i + 3 j ) = v 1 i + v 2 j ⇓ (提取 i , j ) ( v 1 ′ + 3 v 2 ′ ) i + ( 2 v 1 ′ + 3 v 2 ′ ) j = v 1 ^ + v 2 j 也就是
[ v 1 ′ + 3 v 2 ′ 2 v 1 ′ + 3 v 2 ′ ] = [ 1 3 2 3 ] [ v 1 ′ v 2 ′ ] = [ v 1 v 2 ] v ⃗ = C v ⃗ ′ (N2) \left[ \begin{array} { c } v _ { 1 } ^ { \prime } + 3 v _ { 2 } ^ { \prime } \\ 2 v _ { 1 } ^ { \prime } + 3 v _ { 2 } ^ { \prime } \end{array} \right]
= \left[ \begin{array} { l l } 1 & 3 \\ 2 & 3 \end{array} \right] \left[ \begin{array} { l } v _ { 1 } ^ { \prime } \\ v _ { 2 } ^ { \prime } \end{array} \right]
= \left[ \begin{array} { l } v _ { 1 } \\ v _ { 2 } \end{array} \right]
\qquad \color{orange} \vec{v} = C\vec{v}'
\tag{N2} [ v 1 ′ + 3 v 2 ′ 2 v 1 ′ + 3 v 2 ′ ] = [ 1 2 3 3 ] [ v 1 ′ v 2 ′ ] = [ v 1 v 2 ] v = C v ′ ( N2 ) 注意,这个C矩阵就是空间R 2 R^2 R 2 u 1 , u 2 u_1,u_2 u 1 , u 2 Eq(k3) 的C矩阵!
例K1 现在,设
v ⃗ 1 = [ 1 2 3 ] v ⃗ 2 = [ 1 0 1 ] , B = { v 1 , v 2 } , [ a ⃗ ] B = [ 7 − 4 ] \vec { v } _ { 1 } = \left[ \begin{array} { l } 1 \\ 2 \\ 3 \end{array} \right] \quad \vec { v } _ { 2 } = \left[ \begin{array} { l } 1 \\ 0 \\ 1 \end{array} \right],B=\{v_1,v_2\},[\vec{a}]_B= \left[\begin{matrix} 7 \\-4 \\\end{matrix} \right] v 1 = 1 2 3 v 2 = 1 0 1 , B = { v 1 , v 2 } , [ a ] B = [ 7 − 4 ] 那么向量a在标准基下的坐标 a ⃗ \vec{a} a Eq(k3) :
C [ a ⃗ ] B = [ 1 1 2 0 3 1 ] [ 7 − 4 ] = [ 3 14 17 ] = a ⃗ C [\vec{a}]_B = \left[ \begin{array} { l l } 1 & 1 \\ 2 & 0 \\ 3 & 1 \end{array} \right] \left[ \begin{array} { c } 7 \\ - 4 \end{array} \right] = \left[\begin{matrix} 3 \\14 \\ 17 \end{matrix} \right] = \vec{a} C [ a ] B = 1 2 3 1 0 1 [ 7 − 4 ] = 3 14 17 = a 注意,向量a在基B下是2个分量的 [ 7 − 4 ] \left[\begin{matrix} 7 \\-4 \\\end{matrix} \right] [ 7 − 4 ] [ 3 14 17 ] \left[\begin{matrix} 3 \\14 \\ 17 \end{matrix} \right] 3 14 17
例K2. 承接例K1,现在假设知道 d ⃗ = [ 8 − 3 2 ] \vec{d} = \left[\begin{matrix} 8 \\-3 \\ 2 \end{matrix} \right] d = 8 − 3 2 v 1 , v 2 v_1,v_2 v 1 , v 2
C [ d ⃗ ] B = d ⃗ = [ 8 − 3 2 ] C [\vec{d}]_B = \vec{d} = \left[\begin{matrix} 8 \\-3 \\ 2 \end{matrix} \right] C [ d ] B = d = 8 − 3 2 现在我们有了 d ⃗ \vec{d} d [ d ⃗ ] B [\vec{d}]_B [ d ] B C [ d ⃗ ] B C [\vec{d}]_B C [ d ] B c 1 , c 2 c_1,c_2 c 1 , c 2
[ 1 1 2 0 3 1 ] [ c 1 c 2 ] = [ 8 − 3 2 ] \left[ \begin{array} { l l } 1 & 1 \\ 2 & 0 \\ 3 & 1 \end{array} \right] \left[ \begin{array} { c } c_1 \\ c_2 \end{array} \right] = \left[\begin{matrix} 8 \\-3 \\ 2 \end{matrix} \right] 1 2 3 1 0 1 [ c 1 c 2 ] = 8 − 3 2 直接高斯消去解方程组 即可得到 c 1 = − 3 , c 2 = 11 c_1 =-3 ,c_2 =11 c 1 = − 3 , c 2 = 11 [ d ⃗ ] B = [ − 3 11 ] [\vec{d}]_B = \left[\begin{matrix} -3 \\11 \\\end{matrix} \right] [ d ] B = [ − 3 11 ] Eq(K3),我们可以从 C [ a ⃗ ] B C [\vec{a}]_B C [ a ] B a ⃗ \vec{a} a a ⃗ \vec{a} a C [ a ⃗ ] B C [\vec{a}]_B C [ a ] B
现在我们假设 Eq(K1) 的变基矩阵C是可逆的,这意味着什么?
C是方阵,所以 k 就是 n,C矩阵有n个列
C的列是线性独立的
所以,我们有了 R n R^n R n R n R^n R n 任何标准基表示的向量a,也可被基B表示。
可逆的C是很有用的,意味这什么呢?参见 Eq(K3)
在 例K1,我们可用变基矩阵C直接乘以 [ a ⃗ ] B [\vec{a}]_B [ a ] B a ⃗ \vec{a} a
在 例K2, 我们可以解方程组,从标准基下的 a ⃗ \vec{a} a [ a ⃗ ] B [\vec{a}]_B [ a ] B
如果C可逆,那么在 例K2 求 [ a ⃗ ] B [\vec{a}]_B [ a ] B
C [ a ⃗ ] B = a ⃗ ⇒ C − 1 C [ a ⃗ ] B = C − 1 a ⃗ ⇒ [ a ⃗ ] B = C − 1 a ⃗ (K4) \begin{aligned}
&C [\vec{a}]_B = \vec{a} \\
\Rightarrow &C^{-1}C [\vec{a}]_B = C^{-1}\vec{a}\\
\Rightarrow &[\vec{a}]_B = C^{-1}\vec{a}
\end{aligned}
\tag{K4} ⇒ ⇒ C [ a ] B = a C − 1 C [ a ] B = C − 1 a [ a ] B = C − 1 a ( K4 ) 例K3 设 v 1 = ( 1 , 3 ) , v 2 = ( 2 , 1 ) , B = { v 1 , v 2 } v_1 = (1,3),v_2 = (2,1),B = \{v_1,v_2\} v 1 = ( 1 , 3 ) , v 2 = ( 2 , 1 ) , B = { v 1 , v 2 } a ⃗ = ( 7 , 2 ) \vec{a} = (7,2) a = ( 7 , 2 )
解:直接应用Eq(K4) 得到
[ a ⃗ ] B = C − 1 [ 7 2 ] = − 1 5 [ 1 − 2 − 3 1 ] [ 7 2 ] = − 1 5 [ 3 − 19 ] [\vec{a}]_B = C^{-1}\left[\begin{matrix} 7 \\2 \\\end{matrix} \right] =
-\frac{1}{5}\left[\begin{matrix} 1 & -2 \\ -3 & 1 \end{matrix} \right] \left[\begin{matrix} 7 \\2 \\\end{matrix} \right] = -\frac{1}{5}\left[\begin{matrix} 3 \\-19 \\\end{matrix} \right] [ a ] B = C − 1 [ 7 2 ] = − 5 1 [ 1 − 3 − 2 1 ] [ 7 2 ] = − 5 1 [ 3 − 19 ] 以上,C矩阵联系的是一个标准基和1个非标准基,如果2组都是非标准基,需要以标准基作为跳板。
设2组新基
u ⃗ 1 = [ 1 2 ] , u ⃗ 2 = [ 3 3 ] w ⃗ 1 = [ − 1 − 1 ] w ⃗ 2 = [ 3 0 ] \vec { u } _ { 1 } = \left[ \begin{array} { l } 1 \\ 2 \end{array} \right], \vec { u } _ { 2 } = \left[ \begin{array} { l } 3 \\ 3 \end{array} \right] \\
\vec { w }_ { 1 } = \left[ \begin{array} { l } - 1 \\ - 1 \end{array} \right] \vec { w } _ { 2 } = \left[ \begin{array} { l } 3 \\ 0 \end{array} \right] u 1 = [ 1 2 ] , u 2 = [ 3 3 ] w 1 = [ − 1 − 1 ] w 2 = [ 3 0 ] 根据 Eq(K3或N2):
U = [ 1 3 2 3 ] : v ⃗ = U v ⃗ u W = [ − 1 3 − 1 0 ] : v ⃗ = W v ⃗ w \begin{array} { l l }
\mathrm { U } = \left[ \begin{array} { l l } 1 & 3 \\ 2 & 3 \end{array} \right]&: \vec { v }= U \vec { v } _ { u} \\
\mathrm { W } = \left[ \begin{array} { l l } - 1 & 3 \\ - 1 & 0 \end{array} \right]&: \vec { v } = W \vec { v } _ { w }
\end{array} U = [ 1 2 3 3 ] W = [ − 1 − 1 3 0 ] : v = U v u : v = W v w 设为相等,得到
v ⃗ = U v ⃗ u = W v ⃗ w \vec{v}= U \vec { v } _ { u} = W \vec { v } _ { w} v = U v u = W v w 从而得到
v ⃗ u = U − 1 W v ⃗ w v ⃗ w = W − 1 U v ⃗ u (K4-1) \vec{v}_u = U^{-1} W \vec { v } _ { w}\qquad \vec{v}_w = W^{-1} U \vec { v } _ { u} \tag{K4-1} v u = U − 1 W v w v w = W − 1 U v u ( K4-1 )
transformation matrix with respect to a basis
设变换T是 R n R^n R n R n R^n R n (sp-mark-A2),而且变换可用矩阵A表示,也就是 T ( x ⃗ ) = A x ⃗ T(\vec{x}) = A\vec{x} T ( x ) = A x
这时候,A称为:T变换的变换矩阵(A is the transfomation matrix for T )
但在上一节,我们学习了,同一个向量,在不同的基下,有不同的坐标!当我们写下向量 x ⃗ \vec{x} x x ⃗ \vec{x} x 只有当 x ⃗ \vec{x} x 。更严谨的说法是:A是T变换关于标准基的变换矩阵(A is the transfomation matrix for T with respect to the standard basis ) 也就是说,变换矩阵是绑定在一组基上的! R n R^n R n 同一个变换,在不同的基下的变换矩阵是不一样的! (Mark-k1)
现在,设 B = { v 1 . . . v n } B = \{v_1...v_n\} B = { v 1 ... v n } R n R^n R n [ x ⃗ ] B [\vec{x}]_B [ x ] B [ T ( x ⃗ ) ] B [T(\vec{x})]_B [ T ( x ) ] B
如果从标准基的向量 x ⃗ \vec{x} x T ( x ⃗ ) = A x T(\vec{x}) = Ax T ( x ) = A x
但如果我们从非标准基 的 [ x ⃗ ] B [\vec{x}]_B [ x ] B [ T ( x ⃗ ) ] B [T(\vec{x})]_B [ T ( x ) ] B T还是同1个变换。
sp:注意这里几个字母的概念
1 基B的变基矩阵是C,也就是
Eq(k3):标准基下的坐标转换为基B下的坐标:C [ a ⃗ ] B = a ⃗ C [\vec{a}]_B = \vec{a} C [ a ] B = a
Eq(k4):基B坐标转换为标准基下的坐标:[ a ⃗ ] B = C − 1 a ⃗ [\vec{a}]_B = C^{-1}\vec{a} [ a ] B = C − 1 a
2 标准基下 x 的T变换对应的矩阵是A,也就是 T ( x ) = A x T(x) = Ax T ( x ) = A x
3 基B下 [ x ] B [x]_B [ x ] B T ( [ x ] B ) = D [ x ] B T([x]_B) = D[x]_B T ([ x ] B ) = D [ x ] B
下文的 T ( [ x ] B ) , [ T ( x B ) ] T([x]_B),[T(x_B)] T ([ x ] B ) , [ T ( x B )]
现在,假设 [ x ⃗ ] B [\vec{x}]_B [ x ] B [ T ( x ⃗ ) ] B = D [ x ⃗ ] B [T(\vec{x})]_B =D[\vec{x}]_B [ T ( x ) ] B = D [ x ] B
回顾一下 Eq(k3,K4),也就是向量的坐标在标准基和非标准基之间的切换。因为T是同1个变换,所以我们可以得到
[ T ( x ⃗ ) ] B = D [ x ⃗ ] B = [ A x ⃗ ] B (K5) [T(\vec{x})]_B =D[\vec{x}]_B =
\color{orange} [A\vec{x}]_B \tag{K5} [ T ( x ) ] B = D [ x ] B = [ A x ] B ( K5 ) 注意 [ A x ⃗ ] B [A\vec{x}]_B [ A x ] B T ( x ) = A x T(x) = Ax T ( x ) = A x
x经过T变换到 T(x)=Ax 再用基B表示得到 [ A x ⃗ ] B [A\vec{x}]_B [ A x ] B
[ x ⃗ ] B [\vec{x}]_B [ x ] B [ T ( x ⃗ ) ] B = D [ x ⃗ ] B [T(\vec{x})]_B =D[\vec{x}]_B [ T ( x ) ] B = D [ x ] B
应该是等价的! 也就是 D [ x ⃗ ] B = [ A x ⃗ ] B D[\vec{x}]_B = [A\vec{x}]_B D [ x ] B = [ A x ] B Eq(K4,K3):
[ A x ⃗ ] B = C − 1 ( A x ⃗ ) ⏟ Eq(K4) = C − 1 A x ⃗ = C − 1 A ( C [ x ⃗ ] B ) ⏟ Eq(K3) (K6) [A\vec{x}]_B = \underbrace{ C^{-1} (A\vec{x})}_{\color{orange} \text{Eq(K4)}} =
C^{-1}A\vec{x} =
C^{-1}A \underbrace{ \left( C [\vec{x}]_B \right)}_{\color{orange} \text{Eq(K3)}}
\tag{K6} [ A x ] B = Eq(K4) C − 1 ( A x ) = C − 1 A x = C − 1 A Eq(K3) ( C [ x ] B ) ( K6 ) 最终,我们得到
D [ x ⃗ ] B = C − 1 A C [ x ⃗ ] B ⇒ D = C − 1 A C (K7) D[\vec{x}]_B =C^{-1}A C [\vec{x}]_B \Rightarrow\quad D = C^{-1}AC \tag{K7} D [ x ] B = C − 1 A C [ x ] B ⇒ D = C − 1 A C ( K7 ) 所以,基B下的向量 [ x ⃗ ] B [\vec{x}]_B [ x ] B [ T ( x ⃗ ) ] B = D [ x ⃗ ] B [T(\vec{x})]_B =D[\vec{x}]_B [ T ( x ) ] B = D [ x ] B
**(转换到标准基) **变基矩阵C乘以[ x ⃗ ] B [\vec{x}]_B [ x ] B C [ x ⃗ ] B C[\vec{x}]_B C [ x ] B C [ x ⃗ ] B = x ⃗ C[\vec{x}]_B=\vec{x} C [ x ] B = x
(在标准基下应用变换) 第1步得到了 x ⃗ \vec{x} x A x ⃗ ( = A C [ x ⃗ ] B ) A\vec{x} (= AC[\vec{x}]_B) A x ( = A C [ x ] B ) (转换回去非标准基) 最后,对 A x ⃗ A\vec{x} A x C − 1 A x ⃗ ( = C − 1 A C [ x ⃗ ] B ) C^{-1}A\vec{x}(= C^{-1}AC[\vec{x}]_B) C − 1 A x ( = C − 1 A C [ x ] B )
也就是,非标准基下的==变换==,需要以标准基为跳板。
回顾 <Mark-k1> 这句话,Eq(k7),就是我们得到同一个变换T,在不同基下对应的变换矩阵的方法!
例K4 设 T : R 2 → R 2 T:R^2 \rightarrow R^2 T : R 2 → R 2 T ( x ⃗ ) = A x = [ 3 − 2 2 − 2 ] x ⃗ T(\vec{x})= Ax= \left[\begin{matrix} 3 & -2 \\ 2 & -2 \end{matrix} \right]\vec{x} T ( x ) = A x = [ 3 2 − 2 − 2 ] x B = { [ 1 2 ] , [ 2 1 ] } B= \left\{\left[\begin{matrix} 1 \\2 \\\end{matrix} \right],\left[\begin{matrix} 2 \\1 \\\end{matrix} \right] \right\} B = { [ 1 2 ] , [ 2 1 ] } C = [ 1 2 2 1 ] , C − 1 = − 1 3 [ 1 − 2 − 2 1 ] C = \left[ \begin{array} { l l } 1 & 2 \\ 2 & 1 \end{array} \right],C^{-1} =-\frac{1}{3} \left[ \begin{array}{c c} 1 & -2 \\ -2 & 1 \end{array} \right] C = [ 1 2 2 1 ] , C − 1 = − 3 1 [ 1 − 2 − 2 1 ] T ( [ x ⃗ ] B ) = D [ x ⃗ ] B T([\vec{x}]_B) = D[\vec{x}]_B T ([ x ] B ) = D [ x ] B
D = C − 1 A C = [ − 1 0 0 2 ] D = C^{-1}AC = \left[\begin{matrix} -1 & 0 \\ 0 & 2 \end{matrix} \right] D = C − 1 A C = [ − 1 0 0 2 ] 设 x = [ 1 − 1 ] x= \left[\begin{matrix} 1 \\-1 \\\end{matrix} \right] x = [ 1 − 1 ]
x ⃗ → A T ( x ⃗ ) = A x ⃗ = [ 5 4 ] ↓ C − 1 ↓ C − 1 [ x ⃗ ] B = C − 1 x ⃗ = [ − 1 1 ] → D [ T ( x ⃗ ) ] B = D [ x ⃗ ] B = [ 1 2 ] = [ A x ⃗ ] B = C − 1 ( A x ⃗ ) (K8) \begin{CD}
\vec{x} @>A>> T(\vec{x}) = A\vec{x} =\left[\begin{matrix} 5 \\4 \\\end{matrix} \right]\\
@V V C^{-1} V @V V C^{-1} V\\
[\vec{x}]_B = C^{-1}\vec{x} = \left[\begin{matrix} -1 \\1 \\\end{matrix} \right] @>>D>
[T(\vec{x})]_B = D[\vec{x}]_B = \left[\begin{matrix} 1 \\2 \\\end{matrix} \right] = [\vec{Ax}]_B = C^{-1}(A\vec{x})
\end{CD}
\tag{K8} x ↓ ⏐ C − 1 [ x ] B = C − 1 x = [ − 1 1 ] A D T ( x ) = A x = [ 5 4 ] ↓ ⏐ C − 1 [ T ( x ) ] B = D [ x ] B = [ 1 2 ] = [ A x ] B = C − 1 ( A x ) ( K8 ) 注意以上从 x ⃗ \vec{x} x
x ⃗ \vec{x} x 往右 经过T变换得到 Ax;在往下 变到基B [ A x ⃗ ] B [\vec{Ax}]_B [ A x ] B x ⃗ \vec{x} x 往下 变基到B:[ x ⃗ ] B [\vec{x}]_B [ x ] B 往右 应用T变换::D [ x ⃗ ] B D[\vec{x}]_B D [ x ] B
2种方式是等价的
我们为什么要变基?其实线代就是选择合适基的艺术 ,看2个变化矩阵A和D,A是普通的变换矩阵,但D是对角矩阵啊,它用来做变换矩阵,很容易计算,如果要计算T变换100次,可以先把向量切换到基B下,然后应用对角矩阵D的100次幂,最后在切换回原来的基!
Changing coordinate systems to help find a transformation matrix
设 T : R 2 → R 2 T:R^2 \rightarrow R^2 T : R 2 → R 2
A = [ T ( [ 1 0 ] ) T ( [ 0 1 ] ) ] (K9) A = \left[\begin{matrix}
T(\left[\begin{matrix} 1 \\0 \\\end{matrix} \right])
&
T(\left[\begin{matrix} 0 \\1 \\\end{matrix} \right])
\end{matrix} \right]
\tag{K9} A = [ T ( [ 1 0 ] ) T ( [ 0 1 ] ) ] ( K9 ) 但现在,假设我们想找出关于 L : y = 2 x L:y = 2x L : y = 2 x v 1 = ( 2 , − 1 ) v_1 = (2,-1) v 1 = ( 2 , − 1 ) T ( v 1 ) = ( − 2 , 1 ) T(v_1)= (-2,1) T ( v 1 ) = ( − 2 , 1 )
但我们可以变基啊!把 v 1 , L v_1,L v 1 , L 标准基下求变换矩阵A比较困难的时候,我们先变基,然后求变换矩阵D !而A,D矩阵的联系就是 Eq(K7) 啊!
现在,设L所在的直线是 v 2 = ( 1 , 2 ) v_2= (1,2) v 2 = ( 1 , 2 ) B = { v 1 , v 2 } = { [ 2 − 1 ] , [ 1 2 ] } B= \{v_1,v_2\} = \{\left[\begin{matrix} 2 \\-1 \\\end{matrix} \right],\left[\begin{matrix} 1 \\2 \\\end{matrix} \right]\} B = { v 1 , v 2 } = { [ 2 − 1 ] , [ 1 2 ] }
C = [ 2 1 − 1 2 ] , C − 1 = 1 5 [ 2 − 1 1 2 ] C = \left[ \begin{array} { l l } 2 & 1 \\ -1 & 2 \end{array} \right],
C^{-1} =\frac{1}{5} \left[ \begin{array}{c c} 2 & -1 \\ 1 & 2 \end{array} \right] C = [ 2 − 1 1 2 ] , C − 1 = 5 1 [ 2 1 − 1 2 ] 注意,这时**,v 1 , v 2 v_1,v_2 v 1 , v 2
[ v 1 ] B = [ 1 0 ] , [ v 2 ] B = [ 0 1 ] [v_1]_B = \left[\begin{matrix} 1 \\0 \\\end{matrix} \right],[v_2]_B = \left[\begin{matrix} 0 \\1 \\\end{matrix} \right] [ v 1 ] B = [ 1 0 ] , [ v 2 ] B = [ 0 1 ]
sp:基向量在自身基下,当然是(1,0),(0,1)啊
设基B下,反射变换对应的矩阵是D,那么根据Eq(K9)
D = [ [ T ( v 1 ) ] B [ T ( v 2 ) ] B ] = [ D [ v 1 ] B D [ v 2 ] B ] D= \left[\begin{matrix} [T(v_1)]_B & [T(v_2)]_B\end{matrix} \right] =
\left[\begin{matrix} D[v_1]_B & D[v_2]_B\end{matrix} \right] D = [ [ T ( v 1 ) ] B [ T ( v 2 ) ] B ] = [ D [ v 1 ] B D [ v 2 ] B ] 其中
D [ v 1 ] B = [ ∣ ∣ d 1 d 2 ∣ ∣ ] [ 1 0 ] = d 1 ⃗ ; D [ v 2 ] B = [ ∣ ∣ d 1 d 2 ∣ ∣ ] [ 0 1 ] = d 2 ⃗ D[v_1]_B = \left[\begin{matrix} | & | \\d_1 & d_2\\| & |\\\end{matrix} \right] \left[\begin{matrix} 1 \\0 \\\end{matrix} \right] = \vec{d_1}
;\quad
D[v_2]_B = \left[\begin{matrix} | & | \\d_1 & d_2\\| & |\\\end{matrix} \right] \left[\begin{matrix} 0 \\1 \\\end{matrix} \right] = \vec{d_2} D [ v 1 ] B = ∣ d 1 ∣ ∣ d 2 ∣ [ 1 0 ] = d 1 ; D [ v 2 ] B = ∣ d 1 ∣ ∣ d 2 ∣ [ 0 1 ] = d 2 意思就是,求出新的基B下的T变换 [ T ( v i ) ] B [T(v_i)]_B [ T ( v i ) ] B [ T ( v 1 ) ] B [T(v_1)]_B [ T ( v 1 ) ] B 基B的 变换矩阵D乘以基B下 ,基B的基 向量 [ v i ] B [v_i]_B [ v i ] B D [ v i ] B D[v_i]_B D [ v i ] B D [ v i ] B D[v_i]_B D [ v i ] B
现在,在新基B下,因为 v 1 , v 2 v_1,v_2 v 1 , v 2
T变换就是关于y = 2x的反射,所以
v 1 = ( 2 , − 1 ) v_1 = (2,-1) v 1 = ( 2 , − 1 ) [ v 1 ] B = ( 1 , 0 ) [v_1]_B = (1,0) [ v 1 ] B = ( 1 , 0 ) v 2 = ( 1 , 2 ) v_2 = (1,2) v 2 = ( 1 , 2 )
sp:这个例子其实就是切换到特征向量基,求除变换矩阵,然后根据 Eq(k7) 的到标准基下的变换矩阵!
[ T ( v 1 ) ] B = [ − 1 0 ] , [ T ( v 2 ) ] B = [ 0 1 ] [T(v_1)]_B = \left[\begin{matrix} -1 \\0 \\\end{matrix} \right],\quad
[T(v_2)]_B = \left[\begin{matrix} 0 \\1 \\\end{matrix} \right] [ T ( v 1 ) ] B = [ − 1 0 ] , [ T ( v 2 ) ] B = [ 0 1 ] 从而得到,在基B下,T变换的矩阵是
D = [ − 1 0 0 1 ] D = \left[\begin{matrix} -1 & 0 \\ 0 & 1 \end{matrix} \right] D = [ − 1 0 0 1 ] 那么
A = C D C − 1 = 1 5 [ − 3 4 4 3 ] A = CDC^{-1} = \frac{1}{5} \left[\begin{matrix} -3 & 4 \\ 4 & 3 \end{matrix} \right] A = C D C − 1 = 5 1 [ − 3 4 4 3 ] 这样就求出了反射变换在标准基下的变换矩阵A!
1 首先,参见 <#Lk1.2> ,向量坐标变换,也就是变基的时候,有自身的变基矩阵,就是 Eq(K3,K4),设变基矩阵是C,那么
Eq(k3):标准基下的坐标转换为基B下的坐标:C [ a ⃗ ] B = a ⃗ C [\vec{a}]_B = \vec{a} C [ a ] B = a
Eq(k4):基B坐标转换为标准基下的坐标:[ a ⃗ ] B = C − 1 a ⃗ [\vec{a}]_B = C^{-1}\vec{a} [ a ] B = C − 1 a
注意变基矩阵C,是以基B的基向量 作为列的!这是因为,<#Lk1.2.1>,<#Lk1.2.2> 是在标准和非标准之间转换,所以变基矩阵C一定是基B的基向量作为列!其实变基矩阵的求法一定是<#2.1> 的方法
2 变换也有自己的 矩阵!**变换是发生在输入、输出基下面的!**变换前后空间可以不一样,基也可以不一样。如
<#1> 例1的点乘变换,输入向量是三维空间的,输出向量是1维空间的,空间都不一样,基当然也不一样。明显,当输入、输出空间维数都不一样的时候,T对应的矩阵A就不是方阵,如<#1> 例1的3-1的<#1> 例3 的旋转例子当中,输入输出基是一样的<#2.3> 的恒等变换,就是输入、输出空间一样,但基不一样
注意,在 <#Lk1.3>所述的,都是 同一个空间 (R n R^n R n sp-mark-A2标记!).从而得到了同一个 变换,在同一个 空间下,不同基 下的变换矩阵的联系,也就是Eq(k7,k8)!它们是相似矩阵!也就是<V32-2>所讲内容
但不管怎样,变换T对应的矩阵A都是<#2.1>讲述的方法!只是需要
首先确定输入输入空间是否一样
如果一样,在确定输入的基和输入的基是否选择一样的
注意:
T(v) = v的恒等变换一定是在同一个空间下的(从 <#1> 例V2 的sp-mark-A1推断,因为恒等变换后向量形式不变,所以恒等变换输入空间和输入空间是一样的,只是基可能不同! ),因为向量表达式根本没有改变!只是当输入、输出的基不一样的时候,A是变基矩阵
**T(v) = v恒等变换是一种特殊的变换,也就是说,变基矩阵也是一个变换矩阵!**它们的求法都是<#2.1>的方法!变基后,向量在不同基下的坐标不一样,但向量形式不变!如sp-note7.2-6 所述,方程就是 <Lk1.2> 的Eq(N1)!
3 不同基下同一个变换的变换矩阵不同,但性质最好的是特征向量作为基的变换矩阵,如 <#Lk1.4> 所示:先得到特征向量基项的变换矩阵D,然后通过Eq(k7) 得到标准基下的变换矩阵A